● 简介:以时空记忆贯通指令跟随、自主探索与历史回溯,让机器人走得更远,也找得回来。
● 英文标题:Introducing Compass 1: Instruction Following, Exploration and Backtracking in Real-World Navigation
不少视觉语言导航模型在仿真环境中取得高分,到了真实楼道,却可能在转弯后丢失目标。据研究团队报告,上海创智学院等单位联合研发的Compass 1在长时视觉回溯导航上展现出世界领先水平,能够从近2分钟的视觉历史中找回目标线索。在持续历史回溯真机测试中,Compass 1的成功率达到58%,四种对照方法均为0%。
上海创智学院、香港大学、源策未来、硅羽科技(Spatial Robotics)和华为的研究人员共同提出面向开放世界的具身导航基础模型Compass 1,将语言理解、视频生成与动作预测结合,用可回溯的空间历史记忆,把“看见眼前”与“记住走过的路”连接起来。源策未来是上海创智学院孵化的企业。
研究团队首次公开了Compass 1的系统性真机验证结果。主实验覆盖办公室、露台、建筑群和街道四类环境、八类导航任务,每种方法各完成320次测试。香港大学的机器狗展示指令跟随、探索与历史回溯,Spatial Robotics的无人机展示跨本体迁移,街道动态场景测试则呈现了导航面对行人与车辆干扰时的挑战。
Compass 1以单目RGB视频为核心视觉输入,通过历史表征地图组织关键画面、轨迹和朝向,并用结构化推理判断任务阶段、探索方向和历史目标位置。据论文作者所知,Compass 1是全球首个支持近2分钟视觉历史回溯的具身导航基座模型。
在技术报告的真实场景对比测试中,Compass 1整体成功率达到79.4%,表现最好的对照方法为17.8%。当目标离开视野后,模型可以结合此前的关键画面、走过的轨迹和当前朝向,判断该往哪里走。
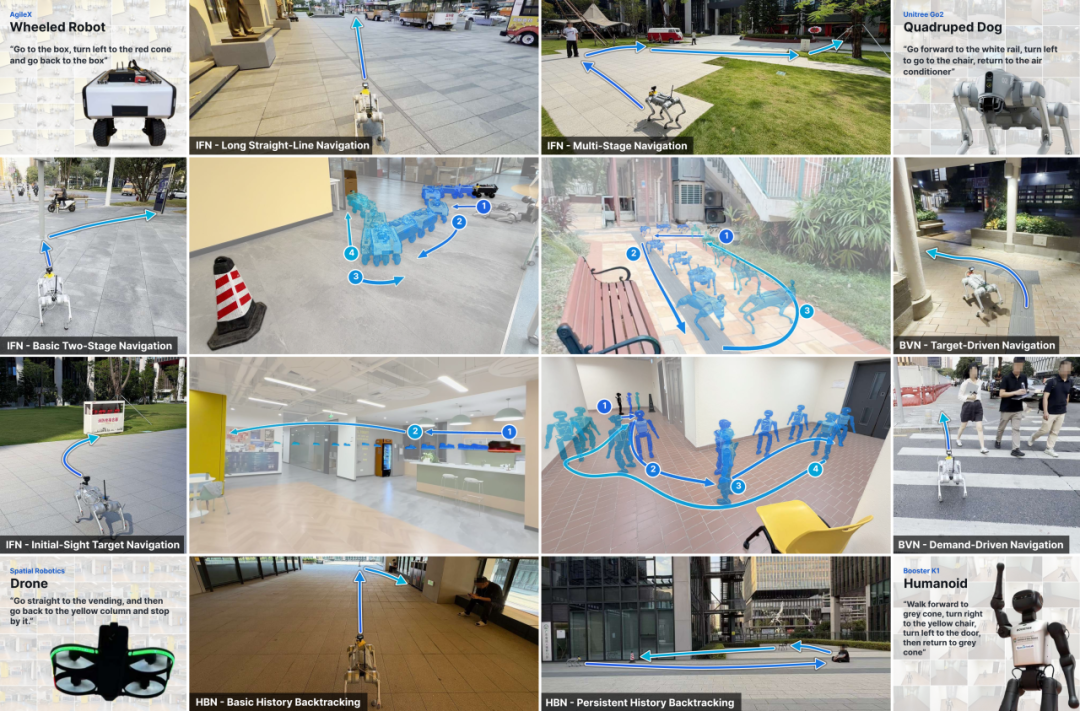
图1|Compass 1在轮式机器人、四足机器人、人形机器人和无人机等不同本体上的真实场景展示
一、导航的下一道难题,不是“走得动”,而是“记得住”
传统导航系统往往依赖激光雷达、深度相机与显式地图;新一代视觉语言导航虽然能理解“直行到黄色椅子,左转到白色垃圾箱,然后寻找自动贩卖机”这样的指令,却容易在真实场景中出现提前停止、转错方向、偏离原始行进方向、左右旋转死循环等问题。更困难的是:目标一旦离开当前视野,模型无法利用几十秒前的信息完成历史回溯。
Compass 1针对上述问题推进了一步:机器人不仅需要识别现在看到什么,还要知道自己走过哪里、正在执行哪一阶段、下一步应该执行什么、何时停止,以及此前见过目标的地方相对于当前位置在哪里。
二、三类真实场景从机器狗到无人机与动态街道
(一)香港大学场景:机器狗走进真实环境
在香港大学的实物验证场景中,宇树Go2四足机器狗搭载约0.5米高度的第一人称相机,在室内外完成语言指令跟随、开放空间探索与历史回溯。四足运动带来的机身抖动,以及不同于训练数据的视角高度,使模型必须在变化的画面中持续判断位置与目标。
机器狗的演示把三类能力串联起来:遇到死胡同后转身脱困,面对多阶段指令按顺序执行,再根据历史画面返回此前的目标位置。它考验的不只是单次转向是否正确,还包括连续行走后,机器人能否记住已经完成的步骤与已经经过的目标。
机器狗的三类导航任务
1/3历史回溯
经过黑色推车和电梯,返回此前见过的路锥。
2/3多阶段指令
依次前往椅子、黑色推车、黄色单车和植物。
3/3自主探索
在走廊里寻找黄色椅子
这里的“单目”指导航模型接收一路相机画面。真机实验中,Go2的底层控制器还会用里程计反馈调节速度。模型负责根据画面和指令决定下一步怎么走,底层控制器负责把动作执行出来。
(二)Spatial Robotics:同一导航能力,飞向空中
Spatial Robotics的无人机测试,把同一导航能力从地面带向空中:摄像头由约0.5米抬升至1.5米,视觉尺度、运动方式和观察视角随之变化。在主要以约1.0米相机高度数据训练的条件下,Compass 1仍展示出零样本跨本体迁移能力。
团队还把相机装在约0.35米高的轮式机器人和约0.85米高的人形机器人上,比较各平台的历史回溯表现。轮式平台行驶较平稳;人形机器人迈步和无人机飞行都会使画面抖动。
同一模型,三种机器人
1/3无人机
飞向自动售货机,再返回黄色立柱旁。
2/3轮式机器人
从纸箱出发,左转前往红色路锥,再返回纸箱。
3/3人形机器人
经过灰色路锥、黄色椅子和门,再返回灰色路锥。
(三)动态街道场景:在行人与车辆之间保持导航目标
从室内走到街道,导航面对的不只是路线变化,还有动态行人与车辆带来的干扰。研究团队在有行人与车辆活动的街道环境中进行了导航测试,并展示了机器人以车辆为目标进行导航的案例。这类场景将问题推进到更开放的环境:机器人需要在变化的视觉信息中持续理解指令,并保持对目标与路径的判断。
街道上的三个导航目标
1/3前往公交站
按“穿过街道,去等公交车”的指令前行。
2/3寻找出租车
根据“我想乘坐出租车”的要求寻找目标。
3/3寻找绿色垃圾桶
沿盲道前行,寻找绿色垃圾桶。
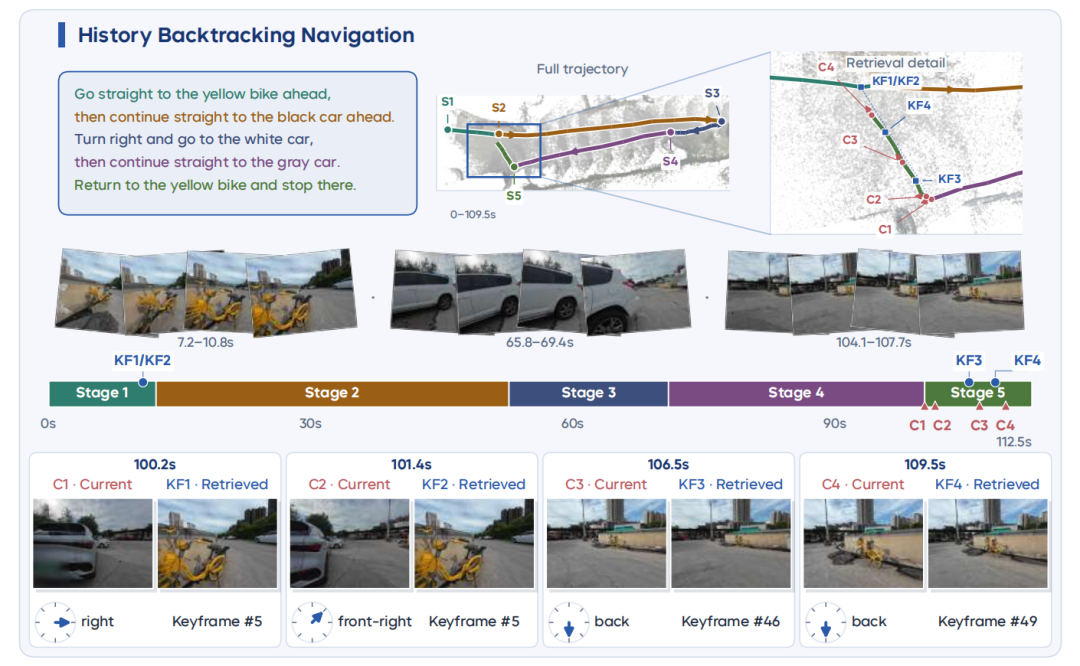
图2|接近两分钟的历史回溯案例:模型根据历史关键帧找回此前经过的目标
以图2的黄色自行车为例,机器人先经过自行车,再依次走向几辆汽车,最后收到返回自行车的指令。在这段预先记录的视频中,模型看到约第100秒的画面时,找回了约第8秒拍到自行车的关键帧,并判断目标在当前朝向的哪一侧。这是一次开环测试,检验的是模型能否从已有录像里找回线索。真机能否沿路返回,要看它边走边决策时的表现。
三、技术如何支撑持续导航
(一)关键一:History Representation Map(HRM),把走过的路“画出来”
历史表征地图HRM将动作轨迹、朝向与关键帧位置组织到一张图中,帮助模型同时理解“看见了什么”和“走到了哪里”。关键帧采样减少重复输入:一分钟、4 FPS的约240帧视频,平均压缩为约40个关键帧,并保留重要转弯与目标信息。部署时,机器人控制误差可能造成微小的动作输出实际不发生转动或转动过大,使得连续历史帧呈现严重非均匀分布。根据前进距离和转角设置阈值保留关键帧能够有效降低该问题。
(二)关键二:结构化VQA,让模型真正“用上”记忆
结构化视觉问答训练模型判断任务执行到哪一步、哪些方向已经探索,以及历史目标出现在哪里。三类监督分别支撑指令跟随、自主探索与历史回溯,使空间记忆能够参与下一步行动判断。团队也逐项移除了这些设计来检验各自的作用。在取消任务阶段问答、改用动作幅度判断何时停止的那组实验中,模型在多阶段指令任务上的成功率降至0%。移除历史目标检索问答后,即使仍能看到轨迹地图,模型也更难利用它找回目标。
(三)关键三:理解与生成统一,兼顾推理和动作执行
统一多模态骨干将语言推理与视频—动作生成结合;部署时通过单GPU异步执行协调动作生成、任务阶段与停止条件判断,让机器人在连续运动中保持任务与执行的一致性。
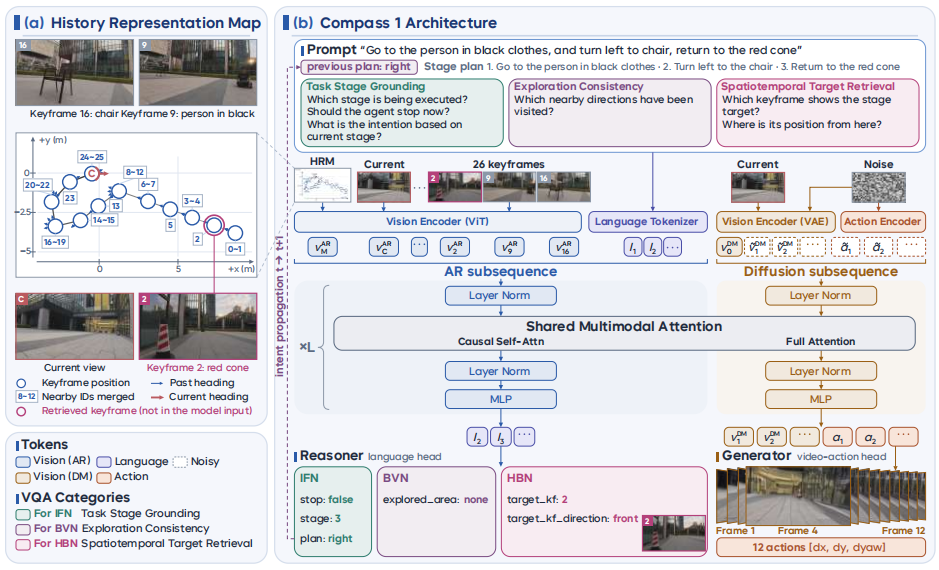
图3|Compass 1的HRM、结构化推理与视频—动作生成框架
(四)数据说话:从“能导航”到“持续导航”
主实验以Go2四足机器人为主要平台。团队在办公室、露台、建筑群和街道分别设置八类任务,每种方法在每个场景的每类任务中独立测试10次,合计320次。四种对照方法均比较了原始开源权重和在团队数据上微调后的表现,取较高结果。
在这组真机测试中,Compass 1的整体成功率为79.4%,四种对照方法中表现最好的AwareVLN为17.8%。具体到任务,Compass 1在初始可见目标导航和基础两阶段导航上分别达到98%和93%,在目标驱动探索和需求驱动探索上分别达到85%和83%。
回头就能重新看见目标,和必须沿来路找回已经消失的目标,是两种难度不同的导航任务。在基础回溯任务中,Compass 1的成功率为98%,表现最好的对照方法为8%。当机器人转身后仍看不到目标、需要沿来路持续回溯时,AwareVLN、LightNav-0、WNM-3D和NaVIDA四种对照方法的成功率均为0%,Compass 1达到58%。团队观察到,即使模型记得目标的大致方位,返程中遇到障碍物遮挡,机器人仍可能走错方向。
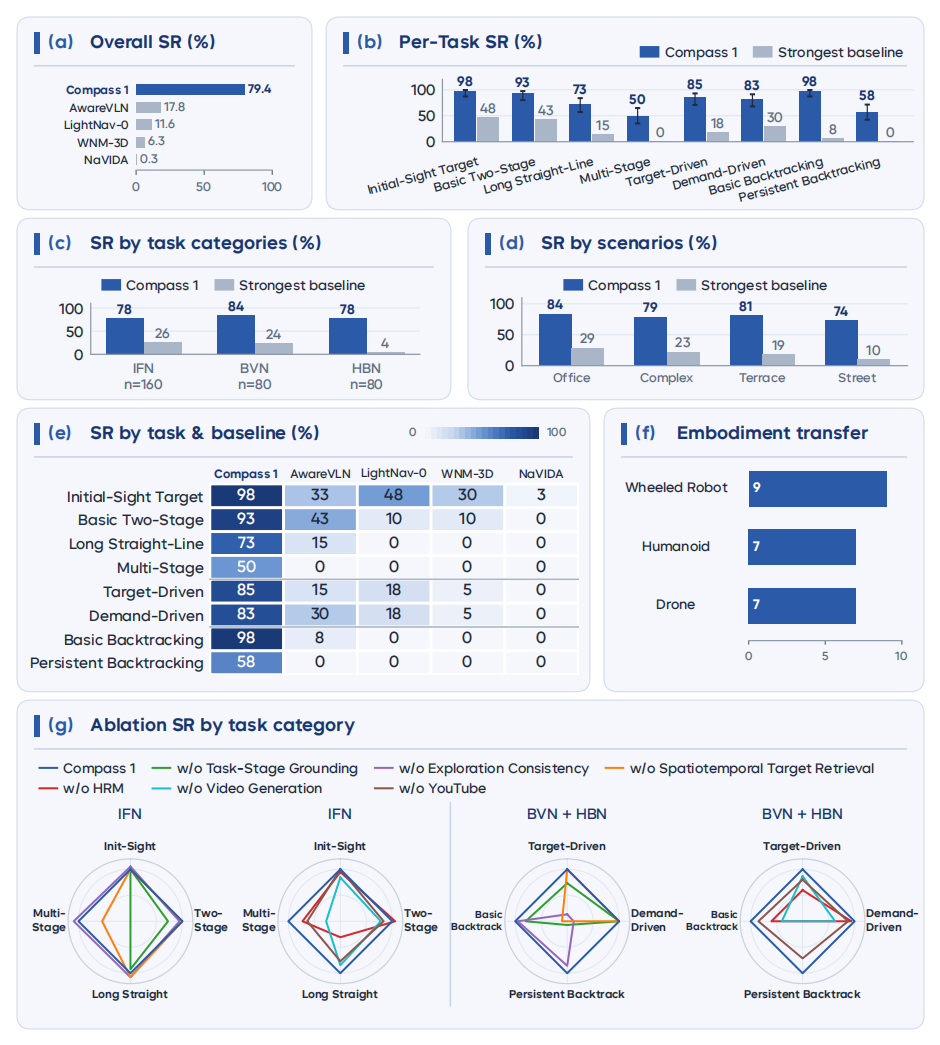
图4|真实世界任务成功率及跨本体迁移实验结果
换到公开的模拟导航基准,差距也会变化。以R2R的未见环境测试为例,在同为单目输入的模型中,Compass 1的成功率为70.1%,LightNav-0为68.5%,相差1.6个百分点。
团队构建半自动视频标注流程,将运动轨迹、阶段指令、关键帧与目标定位监督对齐,整理超过500小时高质量真实交互数据与超过2,000小时标注网络视频,为持续导航提供可扩展的训练基础。
四、一套导航基础模型,走向更多真实世界
Compass 1由上海创智学院、香港大学、源策未来、Spatial Robotics、华为等研究团队提出。从机器狗的真实环境验证,到无人机的跨本体测试,再到动态街道中的导航探索,多方研究共同指向一种能力:让机器人在不同身体和场景中,持续理解任务、利用历史并执行行动。
如果机器人要在陌生楼宇里按指令送回一件物品,它既要记得来路,也要在返程被人挡住、转弯出现偏差后重新找到方向。Compass 1的实验已经给出了前一个问题的具体例子。对于后一个问题,还需要观察机器人在更多地点反复执行任务时,能否自行纠错、抵达目标并准确停下。
● 论文|Compass 1: Towards Open-World and Persistent Embodied Navigation from Monocular RGB Videos
● 项目主页|https://www.archon.tech/research/compass1