一、引言:面向多样化场景,构建通用的人类行为模拟基座
同样面对一次职业选择,有人看重稳定,有人愿意冒险;在一段对话中,有人直接表达诉求,有人会随着关系与情境调整措辞。如果让大模型模拟这些人,它能否保留各自的偏好与行为模式,并在环境变化时作出连贯一致的回应?
随着大语言模型的发展,个体行为模拟正在成为一个越来越重要的研究方向,具备广泛的应用前景。在个性化助手场景,对用户偏好和行为的建模,有望帮助系统更好地适应不同人的需求,提升对真人的服务效果;在教学场景中,模拟具有不同性格习惯、知识基础和理解方式的学习者,可以为教学策略的设计提供测试环境;在游戏中,维持稳定的角色人设、能够根据情境作出即时反应的 NPC,可以给玩家带来更丰富、更有趣的互动体验;在新产品推出前,模拟具有不同需求、偏好与消费习惯的消费者,也可以帮助团队探索不同人群对产品设计、定价与推广方案的潜在反应,为判断市场反馈和设计后续用户调研提供参考。
当模拟对象从一个人扩展到成千上万个相互影响的个体时,个体行为模拟的能力就成为了大规模社会模拟的重要基础。 研究者希望在可控的虚拟环境中,观察信息如何在人群中传播、不同个体如何响应政策或环境变化,以及局部互动如何逐步形成群体层面的现象。这为现实中成本高、难以重复或难以直接开展的研究,提供了补充性的实验工具。
但模拟规模的扩大,也会放大个体行为建模中的偏差。如果不同背景的人都给出同质化的回答,或者智能体在多轮交互中不断偏离自身设定,那么再大的人群规模,也难以弥补个体差异与行为连贯性的缺失。大规模社会模拟对个体行为的真实性、多样性与连贯性提出了更高要求,也推动研究者思考一个问题:能否构建一个可在不同场景中复用的个体行为模拟基座?
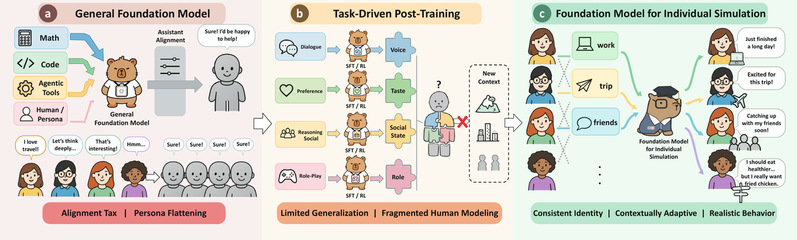 图 1:个体行为模拟需要模型在不同任务和社会情境中保持人物特征,并整合多种互补能力。Socio-Foundation 围绕这一目标组织训练与评测。
近日,来自上海创智学院、复旦大学和腾讯的研究者提出 Socio-Foundation,探索面向多种社会情境的人类行为模拟基座。研究以五维能力体系组织训练任务,通过“任务专家—能力专家—统一模型”的分层训练,将不同场景中的行为能力整合到一个 8B 规模模型中,并构建评测体系 IndiEval。
在论文报告的 IndiEval 评测中,Socio-Foundation 的五维平均分从基座 Qwen3-8B 的 50.7 提升至 61.7,提高 11.0 分,在所有同规模专用模拟模型中取得最高平均分,超越 DeepSeek-V4-Flash(59.7 分),并接近 GLM-5.2(63.2 分)和 GPT-5.5(67.2 分)等前沿大模型的表现。
◾ 个体行为模拟基座与配套代码及数据资源均已公开:
Socio-Foundation-8B|个体行为模拟基座模型:基于 Qwen3-8B,通过分层能力蒸馏整合多类任务的行为专长,支持多样化场景下的个体行为模拟。完整模型权重已公开,可自主部署,无需额外加载任务专家或能力专家。
SocioBank|训练数据资源库:提供约 1,890 万条经过清洗与训练—评测隔离处理的训练记录,覆盖 44 个子集;另提供来自 41 个来源的原始数据,支持个体行为与社会交互模拟研究,以及监督微调(SFT)和强化学习(RL)的数据构建。
IndiEval|个体行为模拟评测体系:围绕五类基础能力构建评测,本次公开 12 个评测子集、4,768 个评测样例。论文评测中的 BehaviorChain 子集涉及 1,529 个样例,因版权限制未纳入本次公开版本,需向原作者申请获取。
论文:Socio-Foundation: A Model for Generalizable Individual Behavior Simulation via Hierarchical Capability Distillation
项目主页:https://sii-research.github.io/socio-foundation/
二、能力体系:用 FONTS 五个维度刻画个体模拟能力
偏好预测、角色对话、目标导向交互,看似不同的任务,是否依赖一些共同的行为能力?现有方法通常通过人物提示词或针对特定任务后训练改善模拟表现,但单个任务上的专长,未必能迁移到新的场景。例如,擅长角色扮演模仿对话的模型,不一定能做出和模拟目标一致的行为决策。此外,这些任务的要求也各有侧重:偏好预测关注个人选择,角色对话强调人物一致性,目标导向交互则看重任务完成。它们的交互形式与反馈信号不同,直接混合训练数据,未必能让模型兼顾各类要求。因此,要构建可复用的模拟基座,需要明确不同任务的背后共享的能力要求,为分散的训练任务建立共同的组织框架。
为此,研究团队提出 FONTS 能力体系,从多样化任务中梳理出五个相互补充的能力维度,为组织训练任务、整合专家经验和设计评测提供共同依据:
能力维度 | 它关注什么? |
F:个体保真度(Persona Fidelity) | 行为是否符合给定人物的特征、偏好与意图? |
O:目标实现(Outcome Realization) | 能否在交互中推进目标,取得符合任务要求的结果? |
N:行为自然性(Behavioral Naturalness) | 表达与互动是否自然,是否呈现合理的行为多样性? |
T:轨迹连贯性(Trajectory Coherence) | 多轮对话与连续行动是否前后衔接、保持一致? |
S:社会情境理解(Social Grounding) | 能否理解他人的认知、信息差异及所处的社会情境? |
这五个维度将分散的任务放进同一套分析框架:一个任务可以同时涉及多种能力,同一种能力也可以在不同任务中接受训练和检验。
围绕这一框架,团队收集并处理了 40 余个数据集、超过 1,900 万条实例,进一步选取 14 个代表性数据集、约 1,000 万条实例,形成用于训练的语料库,为能力学习提供多样化场景。
三、分层训练:让不同专家的经验进入同一个模型
Socio-Foundation 基于 Qwen3-8B,采用分层能力蒸馏,将专长学习与能力整合分开进行。
第一步,训练任务专家。 团队使用 DAPO 强化学习方法,让不同任务专家在各自的任务环境和奖励信号下学习。每个专家先学会解决特定场景中的行为模拟问题,提升任务专长。
第二步,整合能力专家。 按照 FONTS 的五个维度,将相关任务专家的经验通过离线策略蒸馏汇集为五个能力专家。这样,不同任务中的专长被整合为五个可跨任务复用的行为能力。
第三步,训练统一模型。 通过多教师在线策略蒸馏(MOPD),让最终模型在自己生成的交互轨迹上接受能力专家的指导。通过这一过程,五类行为能力被整合到统一模型中,使其能够应对不同场景下的多种行为要求。
这条路径可以概括为:先在具体任务中学出专长,再围绕能力组织经验,最后将它们整合到一个模型中。
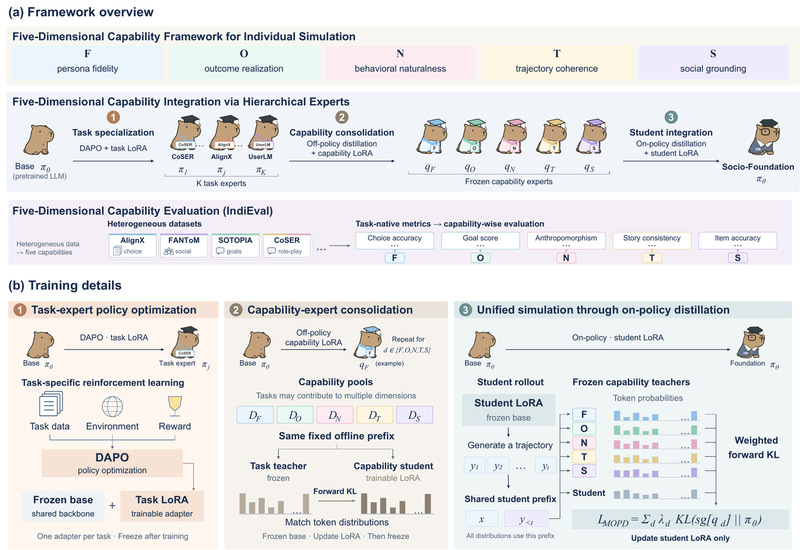 图 2:先通过强化学习获得任务专家,再通过离策略蒸馏形成五个能力专家,最后通过多教师在策略蒸馏训练统一模型。
四、评测体系:从能力出发,让评估目标落到具体场景与指标
如何将“个体保真度”“行为自然性”等等几个维度的抽象能力,转化为能够实际检验的评测呢?团队沿着 “能力维度—评估目标—任务场景与数据集指标” 的路径,构建了一个评测体系 IndiEval 。
首先,团队从 FONTS 的五个能力维度出发,进一步明确模型需要满足哪些可观察的能力要求,形成 11 类评估目标。例如,个体保真度被细化为偏好与决策保真、人物一致的表达与行为、意图一致性;行为自然性则关注类人表达与行为、互动方式和表达多样性。
随后,这些目标被放到具体任务场景中,选择能够检验相应行为的数据集及其原生指标。例如,同样是检验个体保真度,在偏好选择场景中,可以通过选择准确率观察模型是否保留个人倾向;在角色对话场景中,则通过人物保真度指标判断表达与行为是否符合角色设定。能力说明“要测什么”,评估目标明确“观察什么行为”,具体场景与指标则回答“如何测量”。
通过这条路径,IndiEval 将五个能力维度与 13 个基准条目、29 项指标、6,297 个评测案例 联系起来,并保留各基准原有的评测协议。同一数据集也可以通过不同指标检验多种能力,让各项分数对应的能力含义和任务情境都有据可查。
综合得分则先在每个维度内对同一数据集的指标取平均,再对数据集取平均,最后对五个能力维度等权平均,用于汇总模型的整体表现。
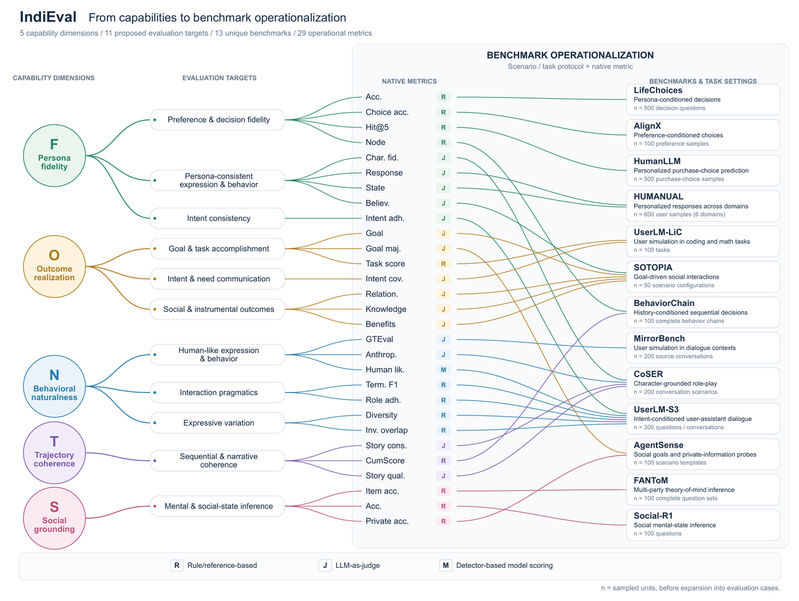 图 3:IndiEval 的构建路径:从五个能力维度出发,细化为 11 类评估目标,再结合具体任务场景,落实为 13 个基准条目中的 29 项原生指标,建立能力、目标、场景与测量方式之间的对应关系。
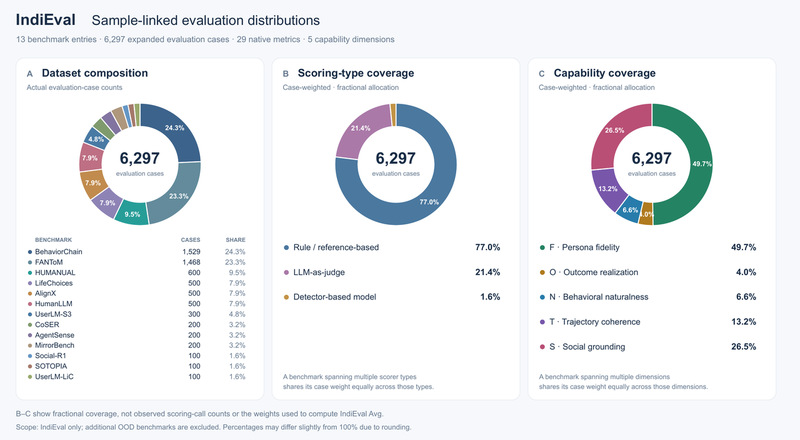 图 4:IndiEval 的案例构成及评分类型、能力维度覆盖分布。对于对应多个类别的基准,案例数量在相关类别间等分,用于描述覆盖比例;该比例不代表综合得分的计算权重。
五、评测结果:8B 模型,在个体模拟评测中逼近前沿大模型
论文实验显示,Socio-Foundation 相比 Qwen3-8B,五个能力维度均有提升,29 项指标中的 24 项取得改善。其中,轨迹连贯性和行为自然性的维度提升最为突出。
在五维平均分上,Socio-Foundation 达到 61.7 分,超过原始基座 Qwen3-8B 的 50.7 分与 当前最强领域基座 OSim 8B 的 55.4 分;与前沿通用模型相比,其得分高于 DeepSeek-V4-Flash 的 59.7 分和 Kimi-K2.6 的 61.2 分,接近 GLM-5.2 的 63.2 分,稍低于 GPT-5.5 的 67.2 分。这表明,围绕个体模拟能力进行有针对性的训练,能够让 8B 规模模型在该专项评测中取得有竞争力的表现。
团队还在 IndiEval 之外,使用 Mistakes、HiToM 和 τ-USI 三项额外基准检验泛化表现。Socio-Foundation 在三项评测中均超过 Qwen3-8B 和 OSim 8B 两个相同基座的对照模型,为方法在额外任务上的迁移能力提供了进一步证据。
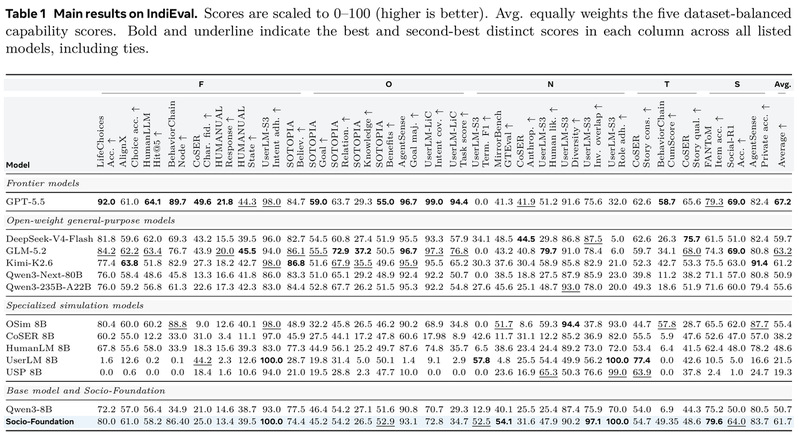 图 5:论文中的 IndiEval 主结果表,包含全部对比模型与 29 项指标。得分采用 0—100 标度,越高越好;Avg. 为五个能力维度的等权平均分。
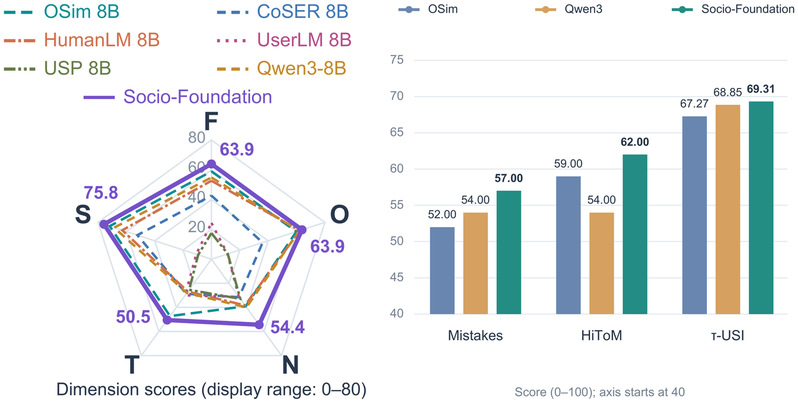 图 6:左图为 Socio-Foundation 与基座及同规模专用模拟模型的五维能力对比;右图为 IndiEval 之外的 Mistakes、HiToM 和 τ-USI 三项额外测试,Socio-Foundation 在三项测试中均优于 Qwen3-8B 与 OSim 8B。右图纵轴从 40 开始,具体分数见柱顶标注。
六、消融分析:分层训练与能力整合为何有效
分层训练中的各个环节是否必要?五类能力专家分别对最终模型有何贡献?直接按照传统方法混合多任务数据直接训练能达到类似的效果吗?研究通过训练策略对照、能力专家消融等实验,进一步分析模型性能提升的来源。
首先,整合专长的方式很重要。 在论文测试的配置下,直接混合任务数据进行监督微调,综合分为 43.0,低于原始基座的 50.7;使用任务专家生成的样本进行微调,得分提升至 59.5,但仍低于完整流程的 61.7。其他对照也表明,能力归并层、基于学生自身生成轨迹的 on-policy 蒸馏,以及蒸馏目标的选择,都影响最终表现。不同任务提供了有价值的经验,而如何组织和传递这些经验,是形成统一能力的关键。
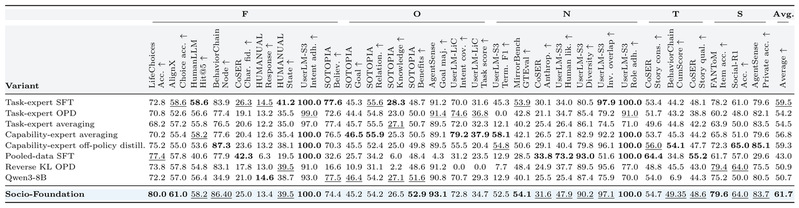 图 7:训练流程消融实验。完整流程在七种替代方案中取得最高综合分;表中同时列出原始基座作为参照。图片由论文原始表格单独导出,可放大查看各项指标。
其次,五类能力对整体表现都有贡献。 逐项移除 FONTS 中任意一类能力专家,对应能力分与综合分都会下降。其中,移除行为自然性专家后,自然性分从 54.41 降至 46.66,综合分从 61.69 降至 59.24,降幅最大。部分配置虽然提高了目标实现分数,整体表现却有所下降,说明单一能力上的提升并不必然带来更好的个体模拟,统一基座需要协调多种行为要求。
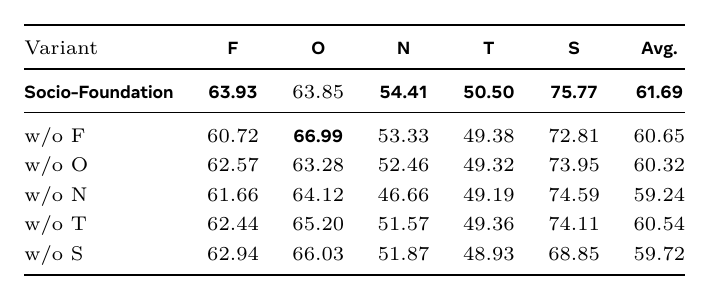 图 8:逐项移除能力专家的对照结果。w/o F、O、N、T、S 分别表示移除对应专家,使用其余四类专家进行多教师在策略蒸馏。保留五类能力专家时,整体综合分最高。
这些实验共同支持了论文的核心思路:将不同任务的专长组织为可共享的行为能力,再整合到统一模型中,有助于构建可在多种场景中复用的个体行为模拟基座。
七、研究展望:迈向更真实、可泛化的个体模拟
Socio-Foundation 围绕一个核心问题展开:如何将不同任务中的行为专长,转化为可跨场景复用的个体模拟能力?通过 FONTS 能力体系、分层能力蒸馏与 IndiEval 评测,研究将能力定义、模型训练和效果检验连接起来,为构建通用的个体行为模拟基座提供了一条可行路径。
面向未来,个体行为模拟需要在更丰富的真实情境中接受检验。 更长时间跨度下的行为一致性、不同人群与文化背景中的适应性,以及复杂互动中的表现,都有待结合真实行为数据进一步研究。可自主部署的小尺寸模型,有望为个性化服务、教学交互、消费者研究及大规模社会模拟提供可复用的基础。尤其当模拟扩展到大量个体时,如何兼顾行为的保真度、多样性、稳定性与计算成本,支持个体间高效的信息交互,并将个体层面的改进转化为更可信的群体行为模拟,是值得持续探索的方向。目前,Socio-Foundation-8B 模型权重、代码、评测数据 IndiEval 与训练数据 SocioBank 均已公开,具体内容及更新进度以对应仓库为准,为进一步开展应用探索与对比研究提供支持。团队期待通过开放模型与研究资源,与社区共同推进这些探索。
让模拟更贴近人,需要跨学科的共同参与。 我们欢迎人工智能、社会学、心理学、经济学、教育学等领域的研究者,以及产业一线的实践者,共同提出应用问题、引入领域知识、完善行为评测,在真实场景中检验模型的能力与边界,让个体行为模拟成为理解人类行为、探索社会现象的有用工具。