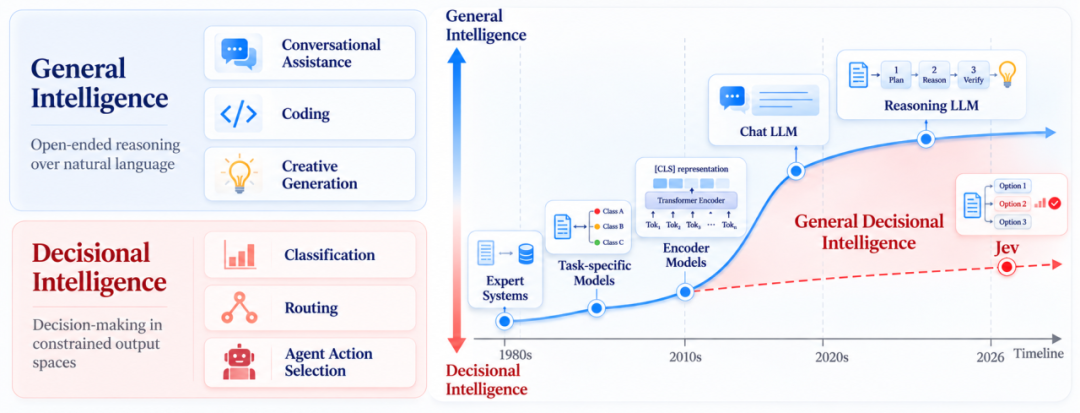
图 1:(左)AI 一方面越来越“通用”,能够聊天、编程和创作;另一方面也需要越来越强的“决策力”,在分类、路由和下一步行动中快速作出选择。(右)从早期专家系统和任务专用模型,到今天的对话、推理大模型,AI 的通用能力不断提升;以 Jev 为代表的通用决策模型则沿着另一条路线继续前进——既要能跨任务泛化,也要能快速作出结构化判断。
● Arxiv链接:https://arxiv.org/pdf/2610.03935
● 项目主页:https://sii-research.github.io/sii-decision/
让 AI 写文章、编代码,它可以洋洋洒洒输出上千字;但如果只是让它从十个候选中选出下一步行动,也需要如此“大费周章”吗?
如今,AI 不仅要能聊天、编程、创作,还要完成分类、路由、偏好判断等决策工作。这背后其实对应着两个重要的能力维度:通用智能(General Intelligence),强调模型能否以较高的智能灵活应对不同领域、不同类型的任务;决策智能(Decisional Intelligence),则关注模型能否在有限的候选方案中作出有效判断。
回顾 AI 的发展历程,早期专家系统和专用模型只能解决特定问题,预训练编码器拓展了模型的迁移能力,却仍往往依赖任务微调。随后出现的LLM则沿着生成式路线不断突破能力边界,让 AI 变得越来越通用,但逐 Token 生成与复杂推理也带来了额外的时间开销。
而近期以 Jev 为代表的模型,正在探索另一片智能空间:既追求大模型跨任务、跨领域的泛化能力,又具备类似人类 System 1 的快速反应能力。我们将这种无需针对每项任务重新训练、便能跨领域作出结构化决策的能力称为通用决策智能(General Decisional Intelligence),具备这一能力的模型则称为通用决策模型(General Decision Models)。
然而这也带来了三个问题:当前通用决策模型的局部决策能力如何,置信度是否可以信任?进入复杂的智能体任务流程中,对于长程决策的精度影响如何?面向局部决策汇总的情形(如社会模拟),又能否还原大规模个体的真实决策结果?
为回答这些问题,来自上海创智学院、复旦大学、同济大学、伦敦国王大学和香港中文大学的研究团队构建了覆盖 10 个领域、11,257 个实例的双语评测基准 JEVal,首次在智能体工作流和大规模社会模拟中探索决策模型的能力边界。同时,团队推出 SII-Decision 4B/27B (原名InnerJev),提出在通用语言模型的基础上,采用思维链自蒸馏的方法,构建高效的通用决策模型,全面开源通用决策模型的复现过程。我们结果表明:
● 通用决策模型在整体准确率上已接近强推理大模型,尤其擅长利用输入中的明确证据快速作出判断,但在专业知识密集型任务和概率估计方面仍存在明显不足。
● 快速的局部决策并不意味着可靠的整体任务表现,尽管引入 Jev 能够缩短任务的中位耗时,但多轮交互中的错误累积仍会导致任务成功率下降、长尾延迟增加。
● 通用决策模型能够以更低的推理成本实现接近强生成式大模型的个体预测效果,但在用户画像、群体结果估计等方面仍存在系统性偏差等挑战。
本次工作全面开源模型训练代码、JEVal 的11,257条评测数据,以及两款模型约4w多条的训练数据和模型权重,其中 SII-Decision 4B 和 SII-Decision 27B 均提供 Full-rank 和 LoRA 两种权重版本,为社区开展模型训练、评测与应用研究提供支持。
一、给 AI 的决策能力来一场全科大考:JEVal 如何评测?
面对不同任务、不同领域和不断变化的候选空间,模型能否灵活理解要求,并快速作出准确判断?为此,我们构建了通用决策评测基准 JEVal,覆盖 10 个应用领域、36 个数据集、58 个子任务,共 11,257 道测试题,包含 9,457 个英文样本和 1,800 个中文样本。从通用知识、医学、法律、金融,到智能体工具使用、社会科学与个性化偏好等多个领域,全面考察模型的决策能力。
为了统一评测不同领域的任务,我们经过数据收集、人工筛选、格式标准化、去重与采样,将任务统一为三个部分:状态(State)、指令(Instruction)和候选结果(Criteria)。在此基础上,JEVal 划分为候选选择(Choice)、二元判断(Noul)和等级评分(Score)三种任务形式。
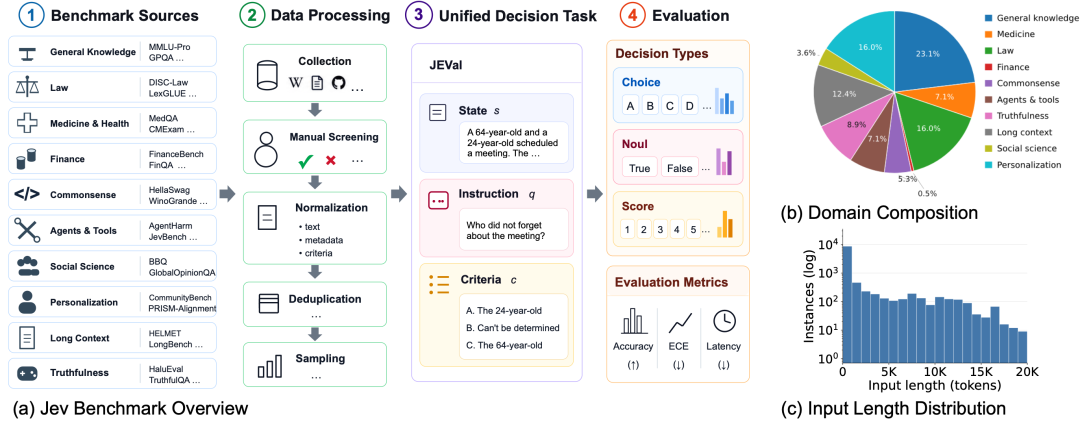
图 2:JEVal 概览。(a)数据处理流程;(b)11,257 个 JEVal 测试实例在各领域的占比分布;(c)使用 cl100k_base 分词器统计的 JEVal 输入长度分布,其中频数轴采用对数刻度。
本次评测汇集了 25 组模型配置,既包括 Jev、Kev、Intern-Decision、SII-Decision 等闭源/开源通用决策模型,也包括 Qwen、DeepSeek、GLM、GPT-6 等生成式大模型,并区分非思考与思考模式,在统一任务下比较不同模型的决策表现。
那么,怎样才算一个优秀的“决策选手”?JEVal 从三个维度进行评价:
● 准确率(Accuracy)衡量模型是否选对答案;
● 置信度校准(ECE、Brier Score)衡量模型给出的概率是否可靠;
● 响应延迟(Latency)衡量模型作出决策的速度。
对于等级评分任务,还进一步考察预测值与真实评分之间的误差(MAE)。
二、LLM 里,原本就藏着一个决策模型
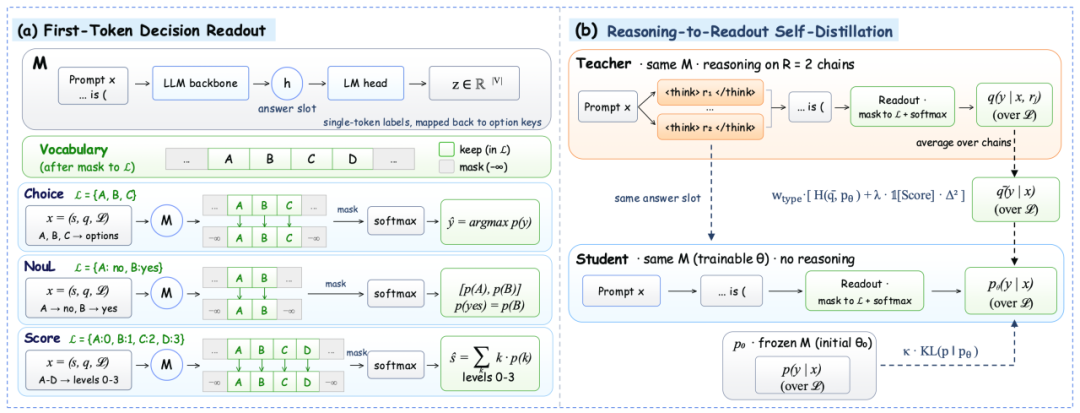
图 3:从开源LLM构建决策模型的方法。(a)First-Token Decision Readout:将答案位置的下一 Token 概率分布限制在有效候选选项的标签上,通过一次前向传播,即可完成预测。(b)Reasoning-to-Readout Self-Distillation:模型首先进行推理,将多条推理链结束时读取的候选概率分布取平均,作为训练目标;随后训练同一模型在不进行推理的情况下,使其首个答案 Token 的概率分布逼近该目标,并通过 KL 散度约束,使其保持接近冻结原始模型的决策分布。
能否让大模型将“深思熟虑”的能力转化为快速的“直觉”,不必每次都经历漫长的推理过程?沿着这一思路,我们提出并开源了通用决策模型 SII-Decision。
事实上,LLM 在生成答案之前,就已经计算出不同 Token 的概率分布。基于此,SII-Decision 采用 First-Token Decision Readout:直接读取候选选项对应的 Token 概率,无需额外增加决策头或逐 Token 生成答案,即可通过一次前向传播完成结构化决策。
但模型的“第一直觉”往往不如深度推理后的判断。为此,SII-Decision进一步提出 Reasoning-to-Readout Self-Distillation:让模型针对同一道问题生成两条独立推理链,将推理结束时的候选概率分布平均后作为学习目标,训练模型在不展开推理的情况下直接作出判断。整个过程无需人工标准答案或更强的教师模型,相当于让模型用自己的“慢思考”训练“快直觉”。
基于这一方法,我们分别以 Qwen3.5-4B 和 Qwen3.8-27B 为基础,构建并开源了 SII-Decision-4B 和 SII-Decision-27B,探索如何将大模型的推理能力转化为高效的单次决策。
(一)发现一:在局部决策任务上,通用决策模型展现准确率与效率优势
通用决策模型交出了一份怎样的成绩单?JEVal 的实验结果揭示了一个令人关注的趋势:无需冗长的推理与文本生成,通用决策模型已经能够在准确率上比肩强大的推理大模型,并在置信度校准和响应效率方面展现出独特优势。
单次前向即可达到与推理大模型相当的准确率。JEVal 的整体评测结果表明,最强的通用决策模型已经能够达到与 Thinking LLM 相当的决策水平。其中,我们提出的 SII-Decision-27B 以 79.24% 的准确率位居所有决策模型首位,超过 Jev 的 78.38%,与开启高强度思考的 Qwen3.8-27B(79.49%)几乎持平,距离表现最好的 GPT-6-Luna(80.93%)也仅有不到 2 个百分点。更小规模的 SII-Decision-4B 同样表现亮眼,超过了同规模的其他决策模型以及 Thinking 模式下的 Qwen3.5-4B。
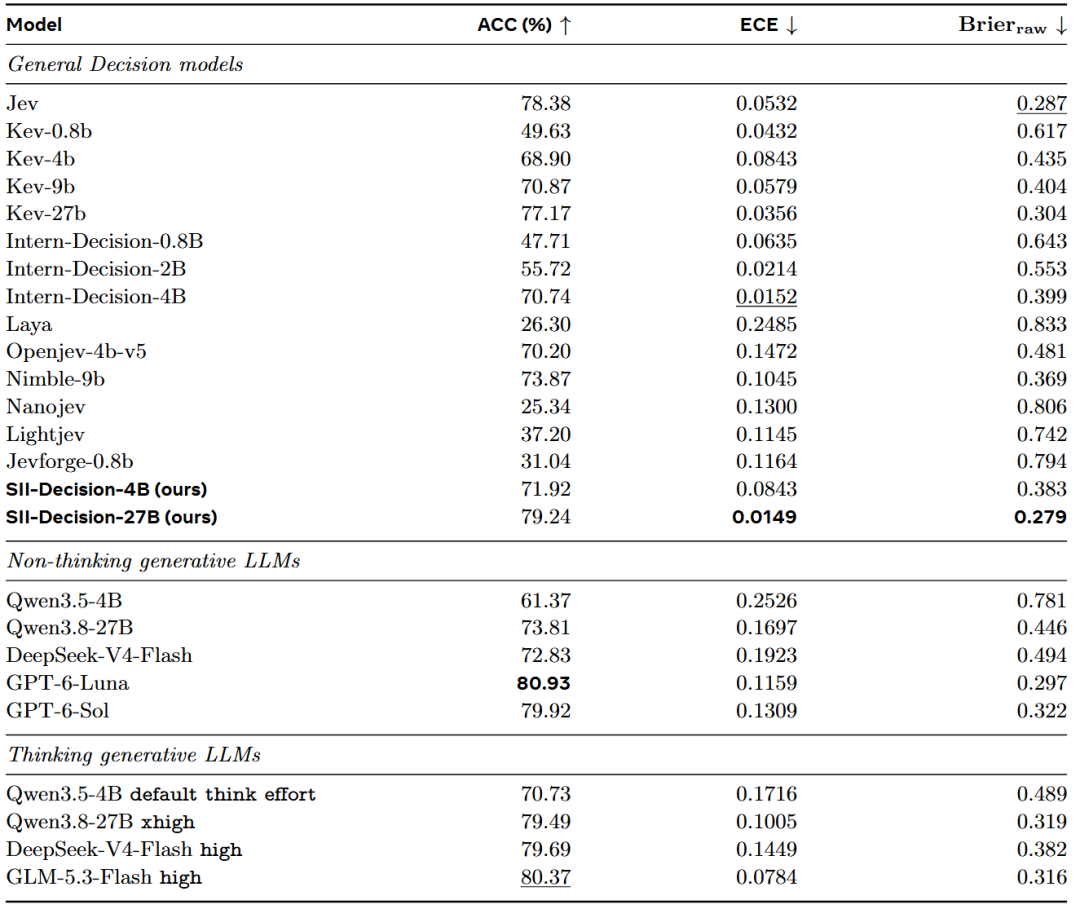
表 1:25 组模型在 JEVal 分类任务上的总体准确率、ECE 和原始概率向量 Brier 误差。
快速决策也有速度边界,SII-Decision 跻身准确率—时延前沿。 在 1K Token 以内的短输入测试中,参评本地决策模型都快于 Jev 托管 API;但随着输入增加,本地模型延迟持续增长,27B 模型在约 2K Token 后开始慢于 Jev,多数 4B 模型的转折点在 4K–8K Token。
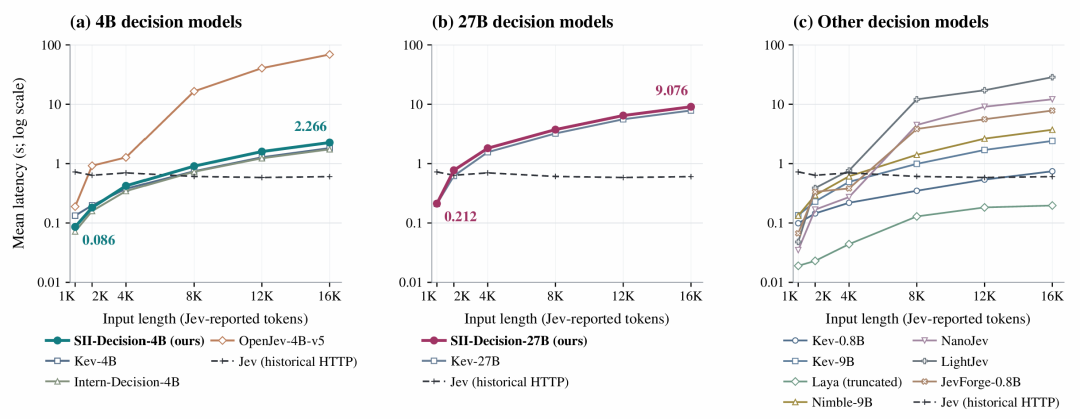
图 4:本地决策模型与 Jev API 在不同输入长度下的响应延迟。
将准确率与短输入延迟同时考察,SII-Decision-4B 和 SII-Decision-27B 均位于帕累托前沿。前者在平均响应时间低于 0.1 秒的模型中准确率最高;后者是准确率最高的决策模型。单张 H100 GPU 上,两者在单张 H100 上、独立单请求测试中的中位延迟分别约为 60 毫秒和 110 毫秒。
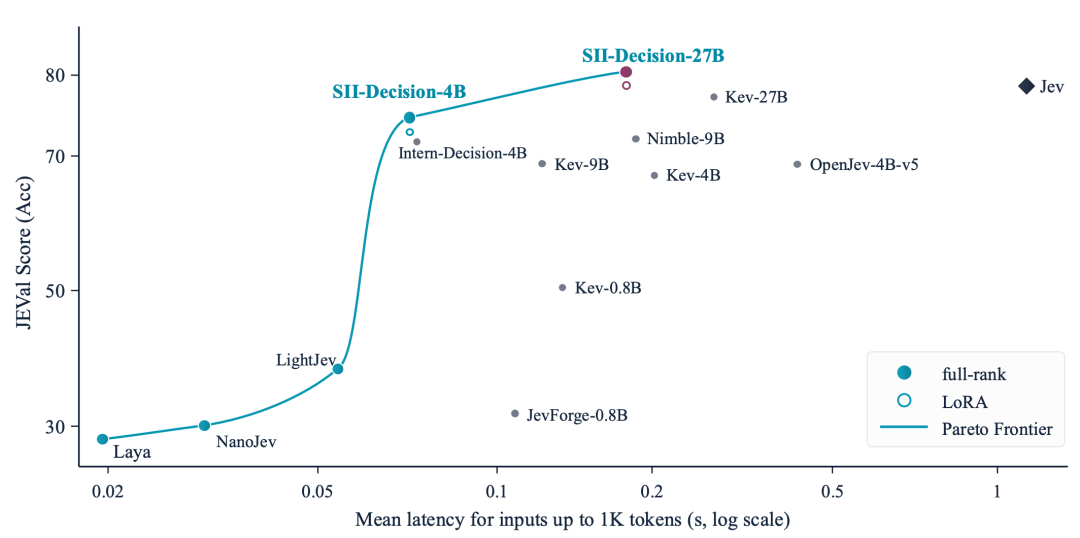
图 5:SII-Decision 在 JEVal 准确率与短输入延迟之间形成的帕累托前沿。
有证据时表现突出,依赖专业知识时仍有差距。 在长上下文与文档理解领域,SII-Decision-27B 和 Kev-27B 分别达到 91.57% 和 90.86%,领先参评生成式模型;智能体工具使用题目中,SII-Decision-27B 距最佳配置仅约 0.5 个百分点。但在医学、金融和法律领域,最佳决策模型仍比最佳生成式 LLM 低约 3–6 个百分点。这表明,直接从输入中定位证据,与调用专业知识作出判断,对模型提出了不同要求。
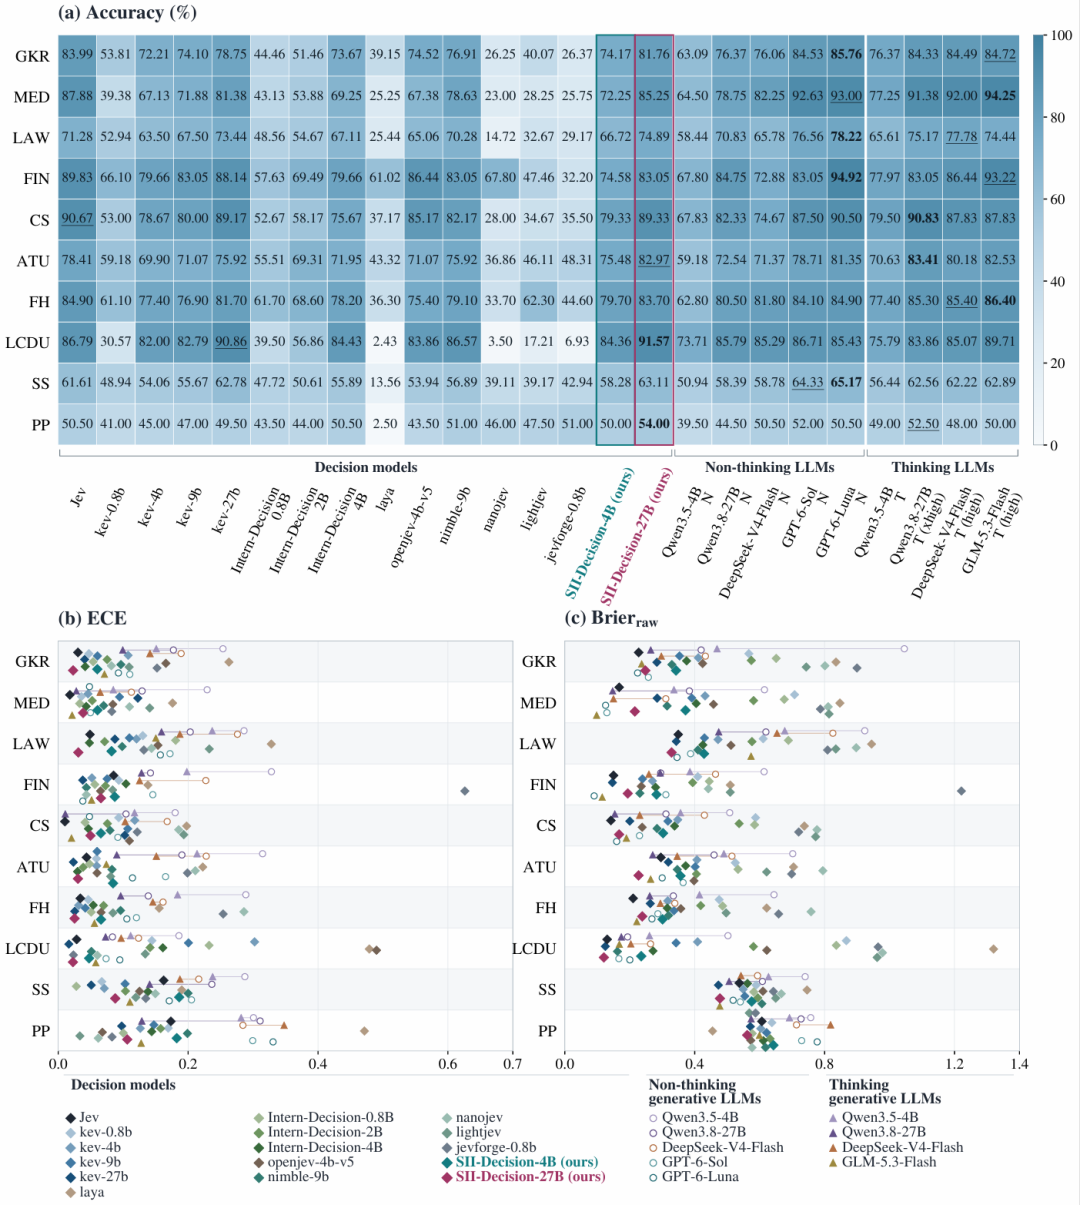
图 6:不同模型在十个领域的准确率、ECE 和 Brier 表现。
校准更好,但也可能高估真实概率。 在 JEVal 上,Jev、Kev-27B、Intern-Decision-4B 和 SII-Decision-27B 的 ECE 均低于参评生成式 LLM,其中 SII-Decision-27B 的 ECE 为 0.0149,Brier 误差也最低。
不过,模型的置信度即使与实际正确率吻合,也不意味着它能准确估计每个选项的真实概率。为此,我们又设计了精确数值与概率实验。Jev 在循环小数除法和面积反推任务中的精确准确率仅为 44% 和 39%,但答案落在正确值 ±1 范围内的比例达到 97% 和 73%。在先验概率题中,它 100% 选中了最可能的答案,却把该选项平均 35.60% 的真实概率估成 89.35%;面对需要结合新证据更新判断的贝叶斯后验题,选对最可能选项的比例又降至 67%。选得对,不代表算得准,更不代表能算准不确定性。
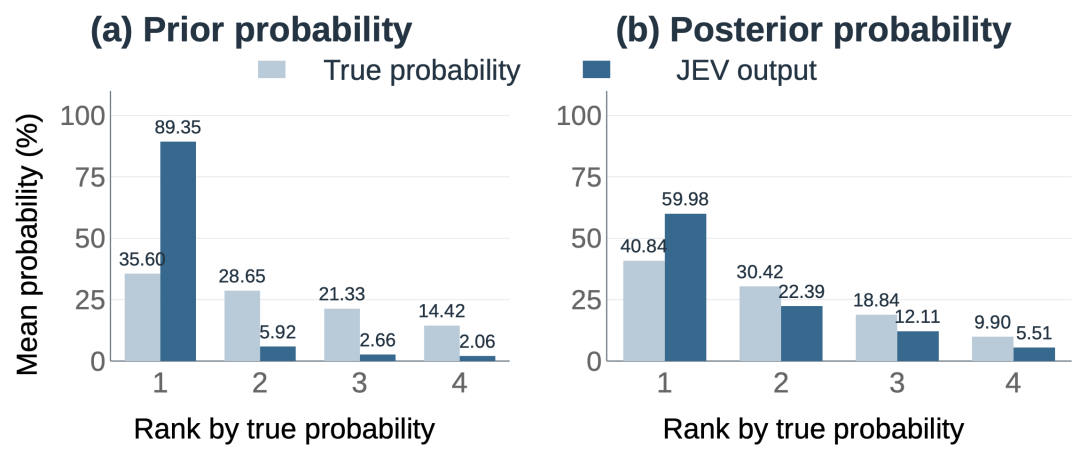
图 7:Jev在先验与后验概率题中的预测概率分布。
Jev依然面临长文本难读的问题。在 JEVal 的文档任务中取得领先,不意味着随着输入变长,准确率不会下降。Jev 在 LongBench 中从 4K–8K Token 时的 93.5% 降至超过 20K Token 时的 74.5%;在 BABILong 中,关键证据落在文本中间时,还会出现与生成式大模型相似的“lost-in-the-middle”现象:Jev 在中间位置区间的准确率低于首尾两侧。
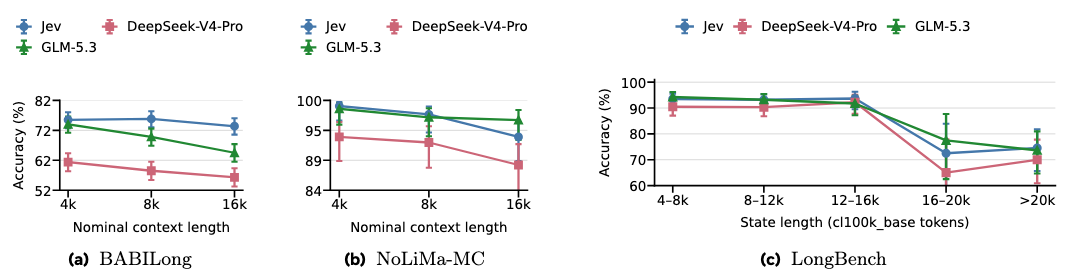
图 8:长上下文能力测试结果。
(二)发现二:单步选择更快,长程智能体的成功率却有所下降
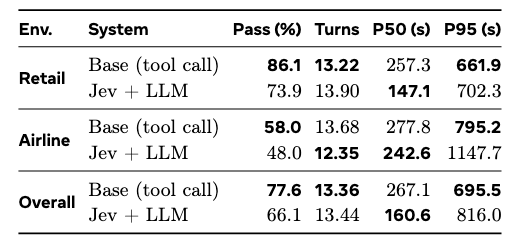
表 2:τ-bench 上的任务成功率、平均交互轮数及 P50、P95 耗时。
如果让模型只做一次选择,它可能表现得又快又准。但如果需要连续作出十几次甚至几十次决策,才能完成一项复杂任务,结果又会如何?为此,我们将 Jev 接入经典智能体评测基准 τ-bench,在零售(Retail)和航空(Airline)两个真实业务场景中展开测试。基线方法由 DeepSeek-V4-Flash 同时负责工具选择与参数生成;引入 Jev 后,则由 Jev 负责选择下一步调用工具,底层 LLM 继续生成工具参数或回复内容,从而比较不同决策方式对完整任务的影响。
实验结果呈现出鲜明的反差:引入 Jev 后,任务的中位完成时间从 267.1 秒缩短至 160.6 秒,但整体成功率却从 77.6% 下降至 66.1%。 与此同时,最慢的 5% 任务耗时进一步增加,P95 延迟从 695.5 秒上升至 816.0 秒。
为什么单步决策更高效,整个任务反而更容易失败?研究发现,在长程交互中,一次错误的工具选择就可能让任务偏离目标,而后续的参数生成错误又可能触发反复查询、重试和纠错,甚至导致任务超时。这些局部错误会随着交互过程不断累积,让原本节省的时间被后续的纠错成本抵消。
这也揭示了通用决策模型从单次判断走向复杂智能体系统时的重要挑战:单次决策的优势,未必能够转化为整个智能体系统的优势。 真正高效的智能体,不仅需要每一步反应迅速,更需要在连续决策中保持稳定并学会纠错。
(三)发现三:个体预测接近大模型,群体估计仍存在偏差
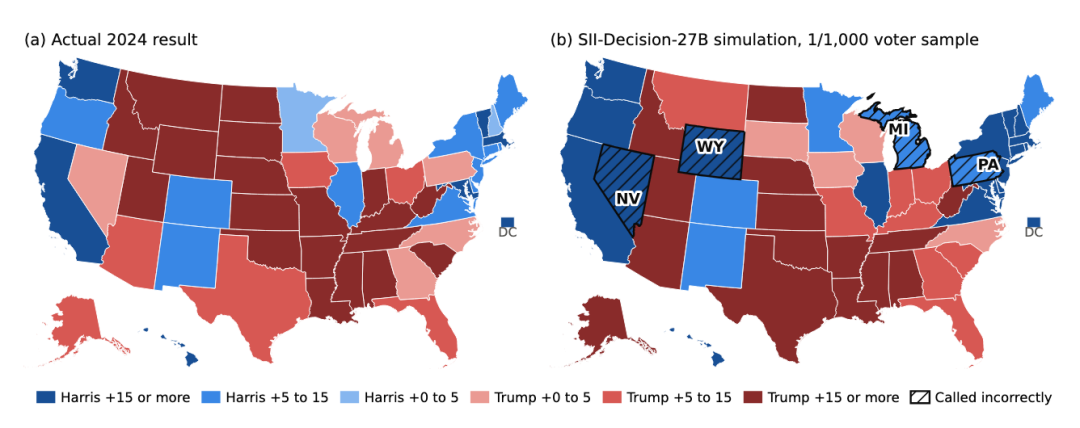
图 9:SII-Decision-27B 模拟的 2024 年美国总统大选州级结果。它能预测多数州的胜负,但具体票份额仍有偏差。
如果让 AI 模拟一个人的选择,或许并不困难;但如果要同时模拟几十万人的行为,快速决策能否真正发挥优势?我们将通用决策模型引入大规模社会模拟,从用户兴趣画像、个体问卷预测到群体选举模拟,逐步考察其在真实社会场景中的表现。
在 898 个社交媒体账号的兴趣画像任务中,Jev 与固定参考画像的 Jaccard 相似度为 53.88%,低于 Qwen3.8-27B 非思考模式的 65.24%,显示出画像一致性方面的差距。
但在个体行为预测上,决策模型展现出了显著的效率优势。在包含 27.75 万条问卷预测样本的 SocioBench 测试中,SII-Decision-27B 取得 39.87% 的准确率,与 Thinking 模式下 DeepSeek-V4-Flash 的 40.41% 十分接近,而平均响应时间仅为 8.36 秒,对比后者的 211.65 秒。
更进一步,我们使用 SII-Decision-27B 模拟了约 33 万名选民参与的 2024 年美国总统大选。结果显示,模型成功预测了 51 个州级选举单位中的 47 个胜负结果,略优于原有 GPT-4o-mini 模拟方案的 46 个。然而,在具体得票率估计上,SII-Decision 的平均绝对误差达到 6.52 个百分点,明显高于原方案的 3.06 个百分点,并表现出系统性高估民主党得票率的倾向。
这一结果揭示了快速决策在大规模社会模拟中的潜力与挑战:决策模型能够以更低成本完成海量个体判断,但当这些判断汇聚为群体结果时,概率估计误差与系统性偏差依然可能影响最终预测。
三、展望:通用决策智能的下一步
从局部决策到长程行动,再到几十万个体的群体聚合,JEVal 的评测与 SII-Decision 的探索展现了通用决策模型在准确性与效率上的巨大潜力,也为未来研究指明了三个重要方向:
1. 迈向大规模群体智能。 通用决策模型的低延迟与低计算成本,为大规模智能体的并行运行提供了新的可能。未来有望支持数百万智能体持续交互、协作与决策,进一步探索复杂社会行为与群体涌现智能。
2. 探索通用决策智能的能力边界。 有限的输出空间并不意味着简单的决策任务。如何进一步提升模型在知识密集型任务、复杂推理、长上下文理解及智能体决策中的能力,缩小与前沿大模型的差距的同时保持速度优势,仍是重要的研究方向。
3. 构建异构智能协作系统。 未来的 AI 系统不必依赖单一模型完成所有任务,而可以让生成式大模型负责复杂推理、规划与内容生成,让通用决策模型承担高频、快速的结构化判断,通过不同智能模块的优势互补,实现系统能力、响应速度与计算成本之间的更优平衡。