近年来,大模型驱动的Vision-Language-Action(VLA)模型正成为具身智能的重要发展方向。从理解自然语言指令,到完成复杂机器人操作,VLA被认为是通向通用机器人智能的重要路径。
不过,一个长期存在的难题始终困扰着这一领域:模型越会"思考",往往越难"动手"。
一方面,越来越多的工作开始让机器人具备Chain-of-Thought(CoT)等推理能力,希望机器人能够像人一样"先思考、后行动";另一方面,高层推理信息却可能干扰底层动作控制,使机器人出现动作迟疑、精细操作能力下降等问题。
与此同时,目前主流VLA模型大多依赖行为克隆(Behavior Cloning)训练,虽然能够很好地拟合专家动作,但一旦部署到真实机器人,闭环执行过程中误差会不断累积,最终导致任务失败。因此,如何将强化学习稳定地应用到真实机器人VLA模型,也成为近年来的重要研究课题。
针对上述问题,来自上海创智学院、上海交通大学卢策吾、叶南阳团队等机构的研究团队在ICML 2026发表论文,提出了新一代Vision-Language-Action模型——SyVLA(Scaling by Diversified Experience for Vision-Language-Action Models)。
一、让机器人"会思考",但不会被思考拖累
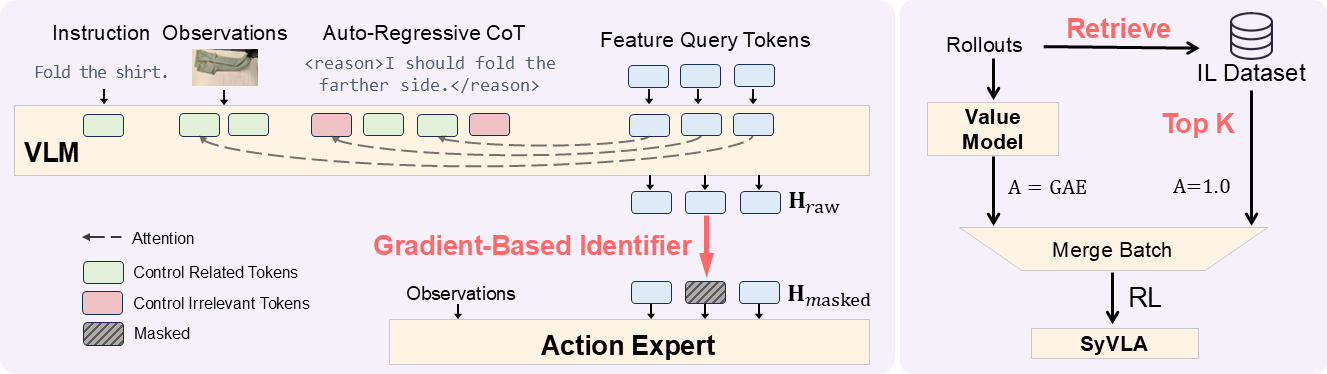
SyVLA整体采用双系统架构。
其中,Qwen2.5-VL负责完成语言理解、视觉理解以及任务规划,而独立的Action Expert则专门负责连续动作生成,两者通过一组Feature Query Token进行连接。
研究团队发现,即使采用这样的设计,高层推理信息依然会混入动作条件表示,使动作模型受到干扰,尤其是在长时序、精细操作任务中容易出现动作不稳定、决策犹豫等问题。
为此,论文提出了Intention Decoupling(意图解耦) 算法。
其核心思想是,根据动作损失对每个Feature Query Token的重要程度,自动识别与机器人控制关系较弱的Token,并在训练阶段将其屏蔽,从而减少高层推理信息泄露,让动作专家更加专注于真正与控制相关的信息。
论文还从理论角度证明,该方法能够有效减少高层推理信息,同时仅带来极小的控制信息损失。
实验结果进一步验证了这一设计的重要性:在折叠衣服任务中,移除意图解耦模块后,模型成功率由86%下降至43%。
二、给真实机器人强化学习加上"安全护栏"
除了动作表示之外,研究团队还关注真实机器人强化学习的稳定性问题。
论文指出,仅依赖行为克隆训练,模型优化的是"每一步动作",而真实机器人最终关心的是"整个任务是否成功"。两者之间存在天然差距,因此需要在线强化学习进一步优化。
然而,真实机器人强化学习通常十分脆弱,策略容易发生崩溃。
对此,SyVLA提出了一套Similar-Sample Guided RL训练流程。
在每次强化学习更新时,除了当前机器人采集的数据之外,系统还会从专家数据集中检索视觉语义最相近的历史样本,与当前数据共同训练。
这些相似样本能够持续约束策略更新方向,使机器人在探索过程中保持合理动作,从而显著提升训练稳定性。
值得注意的是,研究团队还发现,直接对专家数据采用传统PPO优势估计,会导致策略迅速崩溃。因此,论文进一步提出将专家样本优势固定为1,使其等价于行为克隆目标,有效避免了梯度爆炸和策略退化,为真实机器人在线强化学习提供了一种更加稳定的实现方案。
三、用不到Pi0 5%的预训练数据,实现接近甚至超越大型模型的性能
论文在三个真实机器人任务上,对SyVLA与Pi0、GR00T、OpenVLA、ChatVLA等代表性模型进行了系统比较,包括:
长时序精细操作(折叠衣服)
推理与操作结合(数学计算+包装)
模糊语言理解(零食装袋)
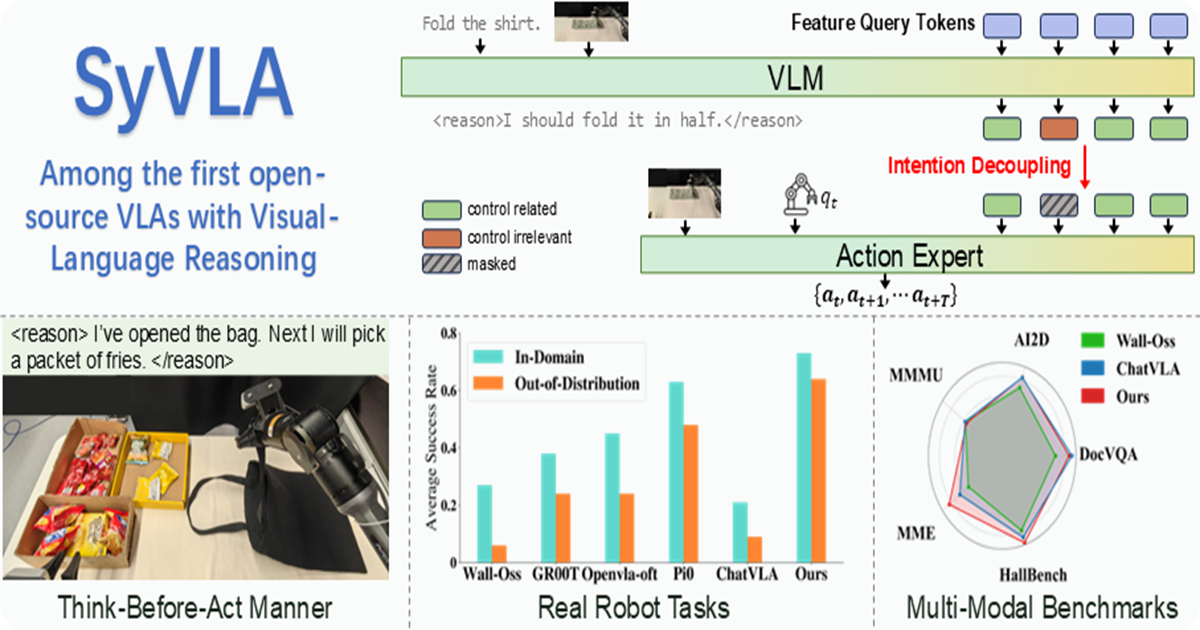
实验结果显示,在域内测试中,SyVLA平均成功率达到73%;在更具挑战性的OoD测试中,平均成功率达到64%,显著优于多种主流基线。
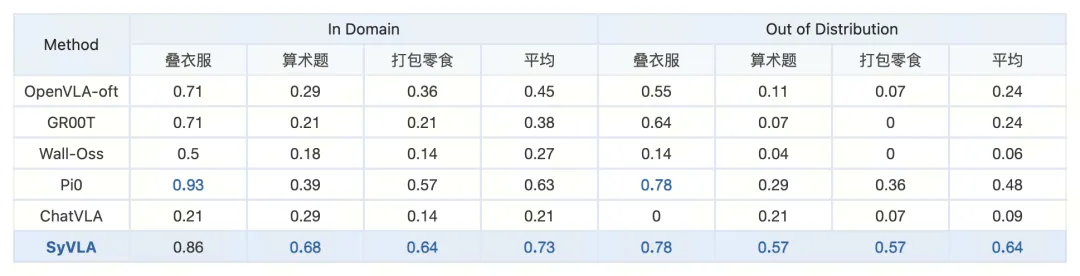 SyVLA在真实世界任务成功率
其中,在需要语言推理的计算包装任务中,SyVLA在OoD环境下取得57%成功率,而官方预训练Pi0为29%,体现了模型较强的推理泛化能力。
更值得关注的是,SyVLA使用的机器人预训练数据规模不足Pi0公开预训练数据的5%,却取得了接近甚至部分超越大型预训练模型的性能。这也说明,相比单纯扩大数据规模,更合理的模型架构和训练策略同样能够显著提升VLA模型表现。
四、保留机器人能力,也保留视觉语言能力
不少VLA模型在机器人训练之后,会出现视觉语言能力明显退化的问题。
SyVLA则采用机器人数据与多模态数据混合训练,在保持机器人操作能力的同时,尽可能保留了原有VLM的视觉理解与推理能力。
Multi-modal Benchmarks
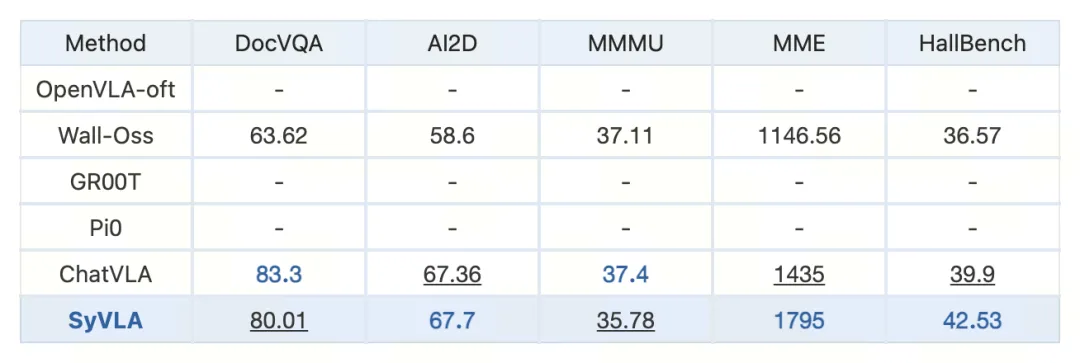 多模态基准结果
在多个视觉语言基准上,SyVLA取得了较好的综合表现,其中MME达到1795分,HallBench达到42.53分,均超过现有多种VLA模型。
论文认为,这使得SyVLA能够在机器人执行能力与通用视觉语言能力之间取得较好的平衡。
五、推动开放VLA生态建设
除了模型本身,研究团队还表示将逐步开源SyVLA相关资源,包括论文、模型权重、训练代码和数据集等,为社区提供更加开放、可复现的VLA研究基础。
随着越来越多VLA模型走向真实机器人应用,如何兼顾推理能力、控制精度和泛化能力,正成为具身智能领域的重要研究方向。SyVLA围绕"推理—控制解耦"和"真实机器人强化学习稳定化"提出了一种新的解决思路,也为开放VLA的发展提供了新的参考。
据介绍,SyVLA也是研究团队打造开放具身智能生态的重要组成部分。依托OpenEAI-Platform,团队正持续推进从自研机械臂、机器人数据采集,到大规模预训练、强化学习和真实机器人部署的全链路开源建设,探索以开放数据、开放算法和开放硬件打造强泛化具身基础模型。未来,团队也期待与更多高校、科研机构及产业伙伴共同推动开放具身智能生态的发展。如对项目合作、联合研究或平台共建感兴趣,可通过项目主页联系进一步交流。
● 项目主页:https://sy-vla.github.io/