科学软件正在成为实验、模拟和发现的一部分。它不只是“能不能运行”的工具,也承载着单位、坐标系、数值不变量、文件格式和物理假设。一个看似很小的代码改动,可能让程序继续运行,却悄悄改变科学结论。近日,上海创智学院邱锡鹏团队发布SWE-bench Science(SWE即Software Engineering):一个面向科学软件工程的仓库级代码智能体评测基准。它要回答的问题很直接:当智能体面对真实的科学软件仓库时,能否完成修复,并且不破坏背后的科学契约?
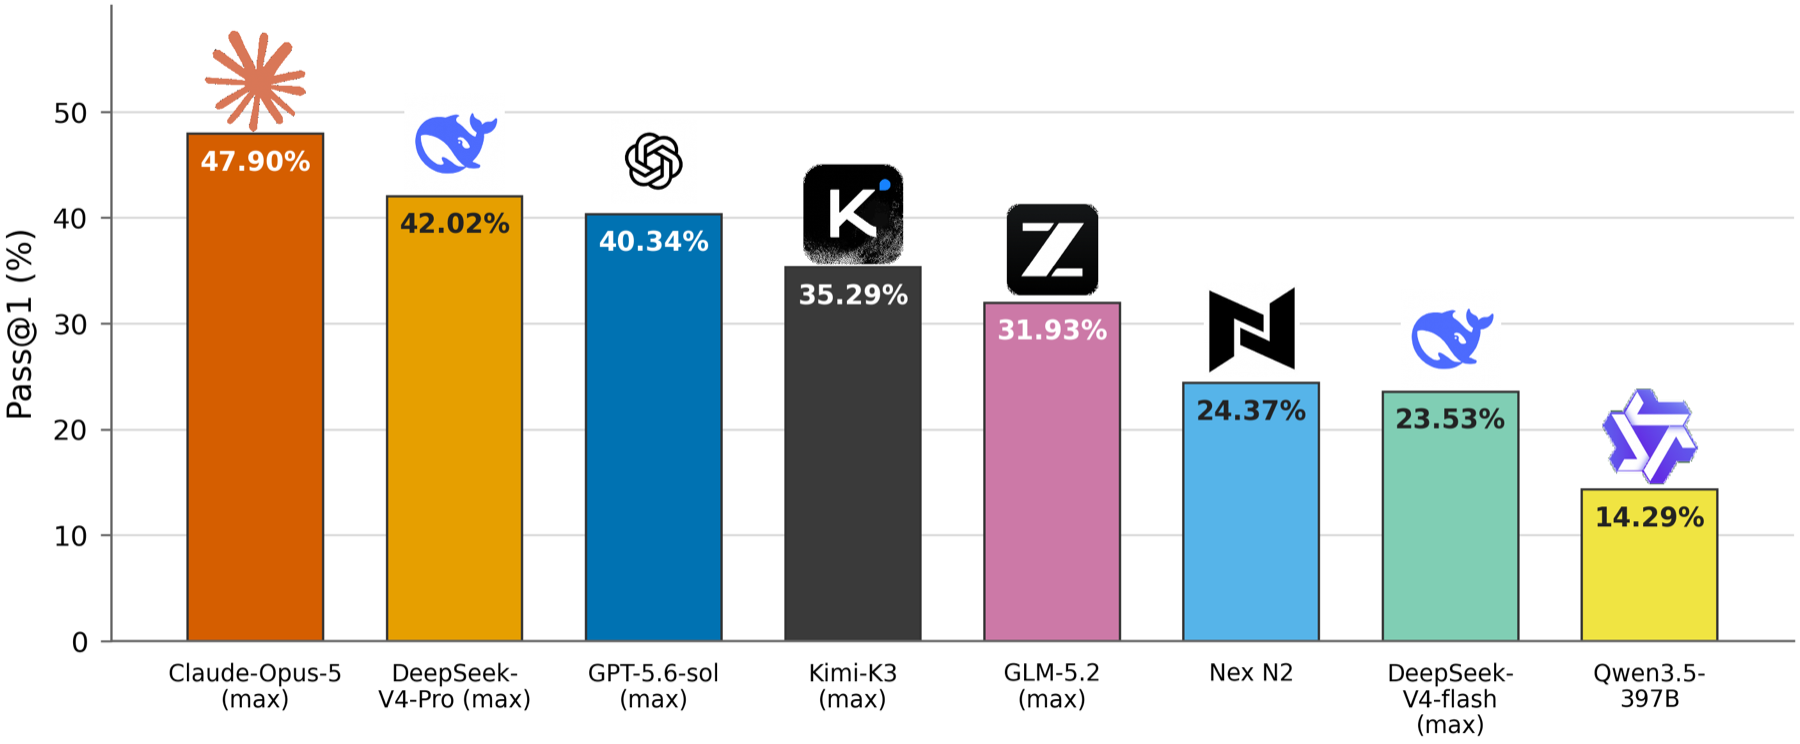
图1|论文报告的代表性代码智能体配置在SWE-bench Science上的Pass@1。
不只是写一道题,而是修复真实科学软件
SWE-bench Science包含119个任务,来自98个GitHub仓库,覆盖20个科学领域,包括化学、材料科学与工程、生物、生物医学工程、物理、数学、天文等。
每个任务都从真实的软件上下文出发:智能体需要阅读仓库、理解问题、修改代码,并通过独立的评测流程验证修复是否完整。评测不只看公开测试是否通过,还会使用隐藏的私有测试检查科学行为和边界条件。
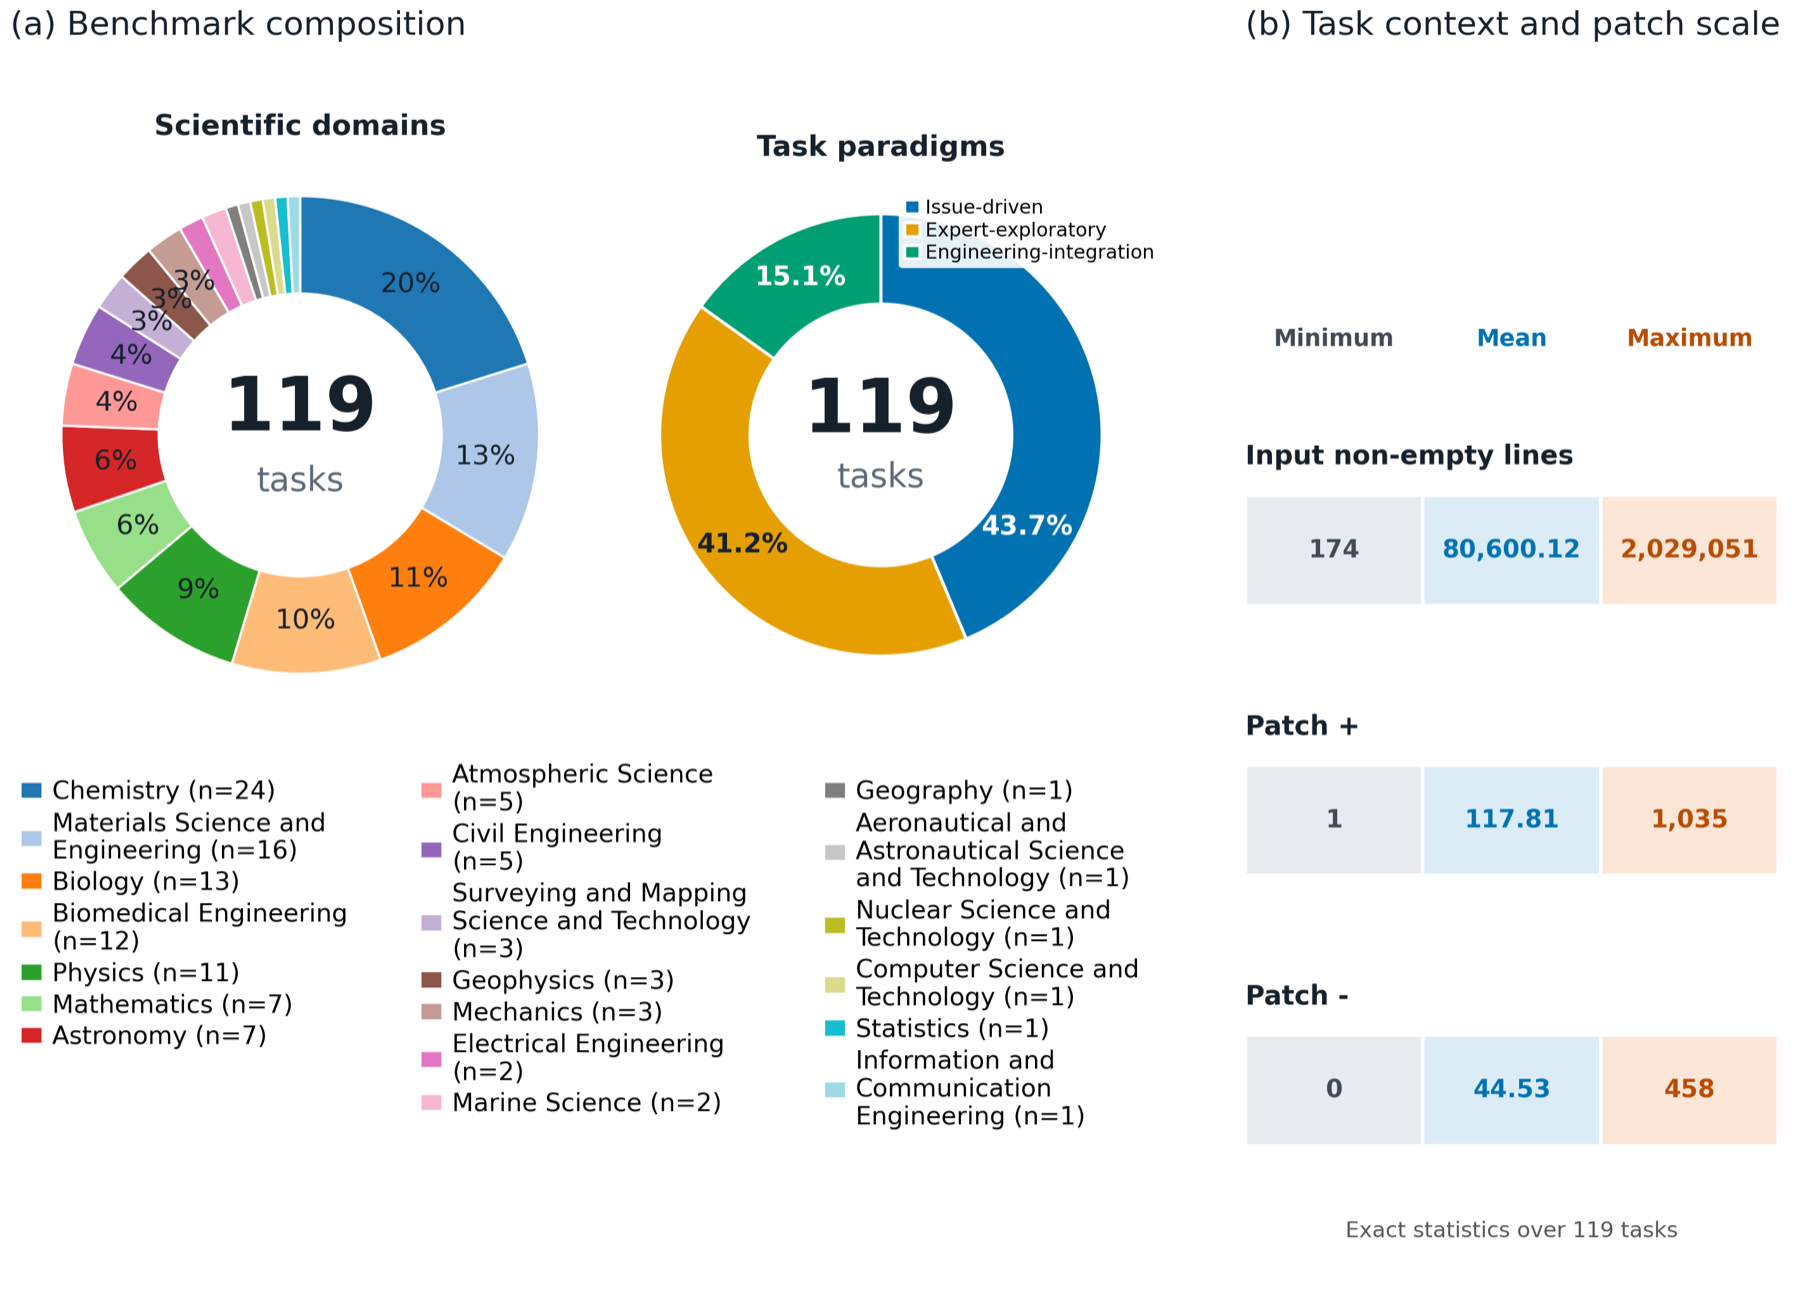
图2|119个任务覆盖20个科学领域,并包含不同规模的代码库与补丁。
三类任务,覆盖科学软件维护的不同难点
为了刻画科学软件工程中不同的工作方式,团队将任务归纳为三类:
Issue-driven|问题驱动
从已知缺陷出发,修复具体问题,同时避免回归。难点在于,表面症状往往只是科学错误在代码中的一个表现。
Expert-exploratory|专家探索
没有现成的标准修复路径,智能体需要自主设计探索方案,定位科学现象与程序行为之间的偏差。
Engineering-integration|工程集成
修复不局限于单个函数,而是需要理解多个模块、数据流和端到端约束,确保整个科学工作流仍然成立。
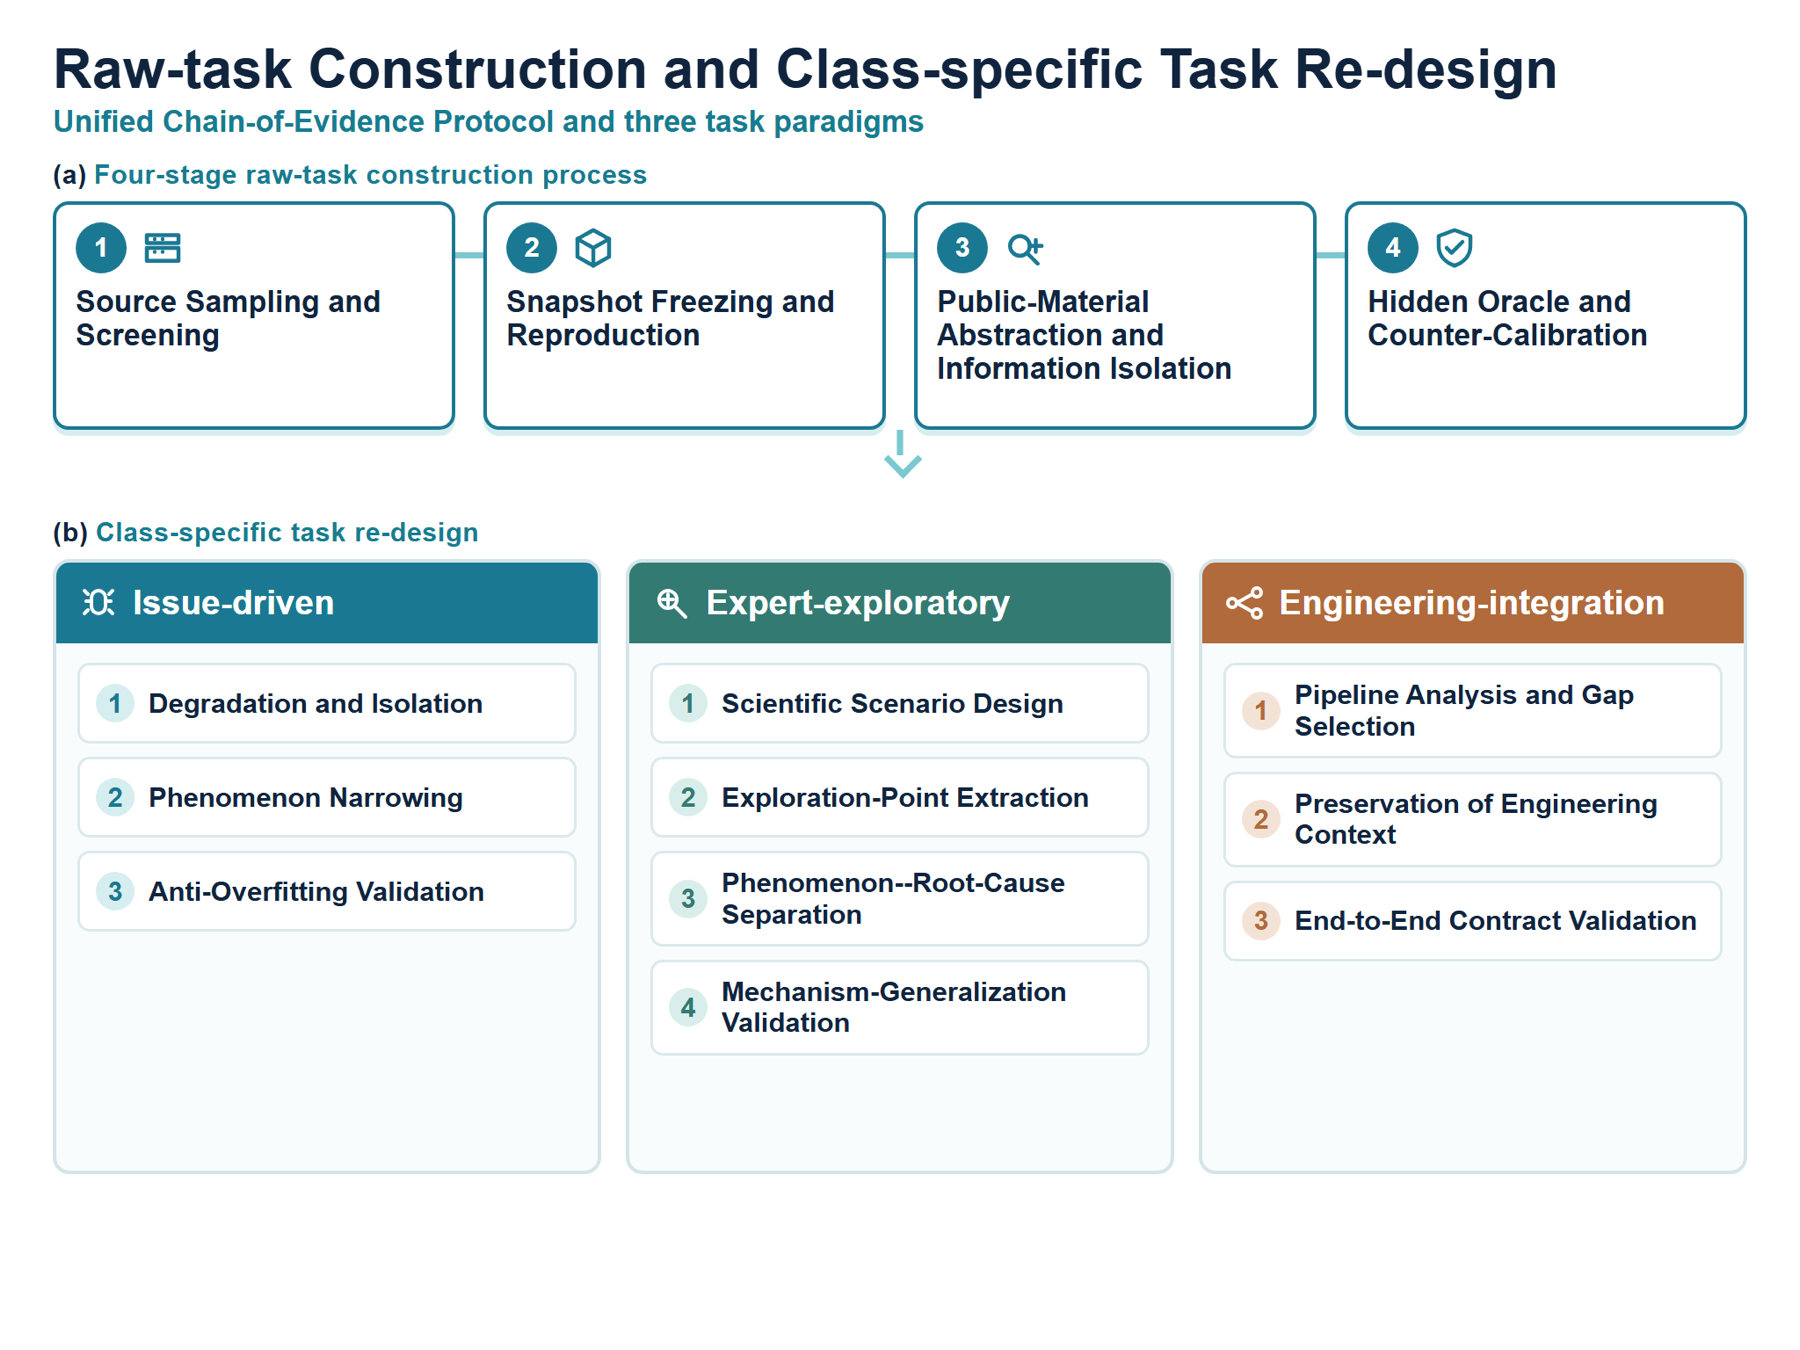
图3|从任务筛选、环境冻结,到科学信息隔离和隐藏验证;下方为三类任务范式。
怎样判断一次修复真的成功?
每个任务都提供一个冻结的代码环境和清晰的问题目标。智能体在可见的工程上下文中进行探索、编辑和测试,最终提交代码补丁;随后,评测器在干净环境中分别运行公开测试和私有测试。团队重点报告Pass@1:只有当一个任务的所有适用私有测试都通过时,才计为成功。这一指标比“通过了几个公开测试”更严格,也更接近完整修复的要求。
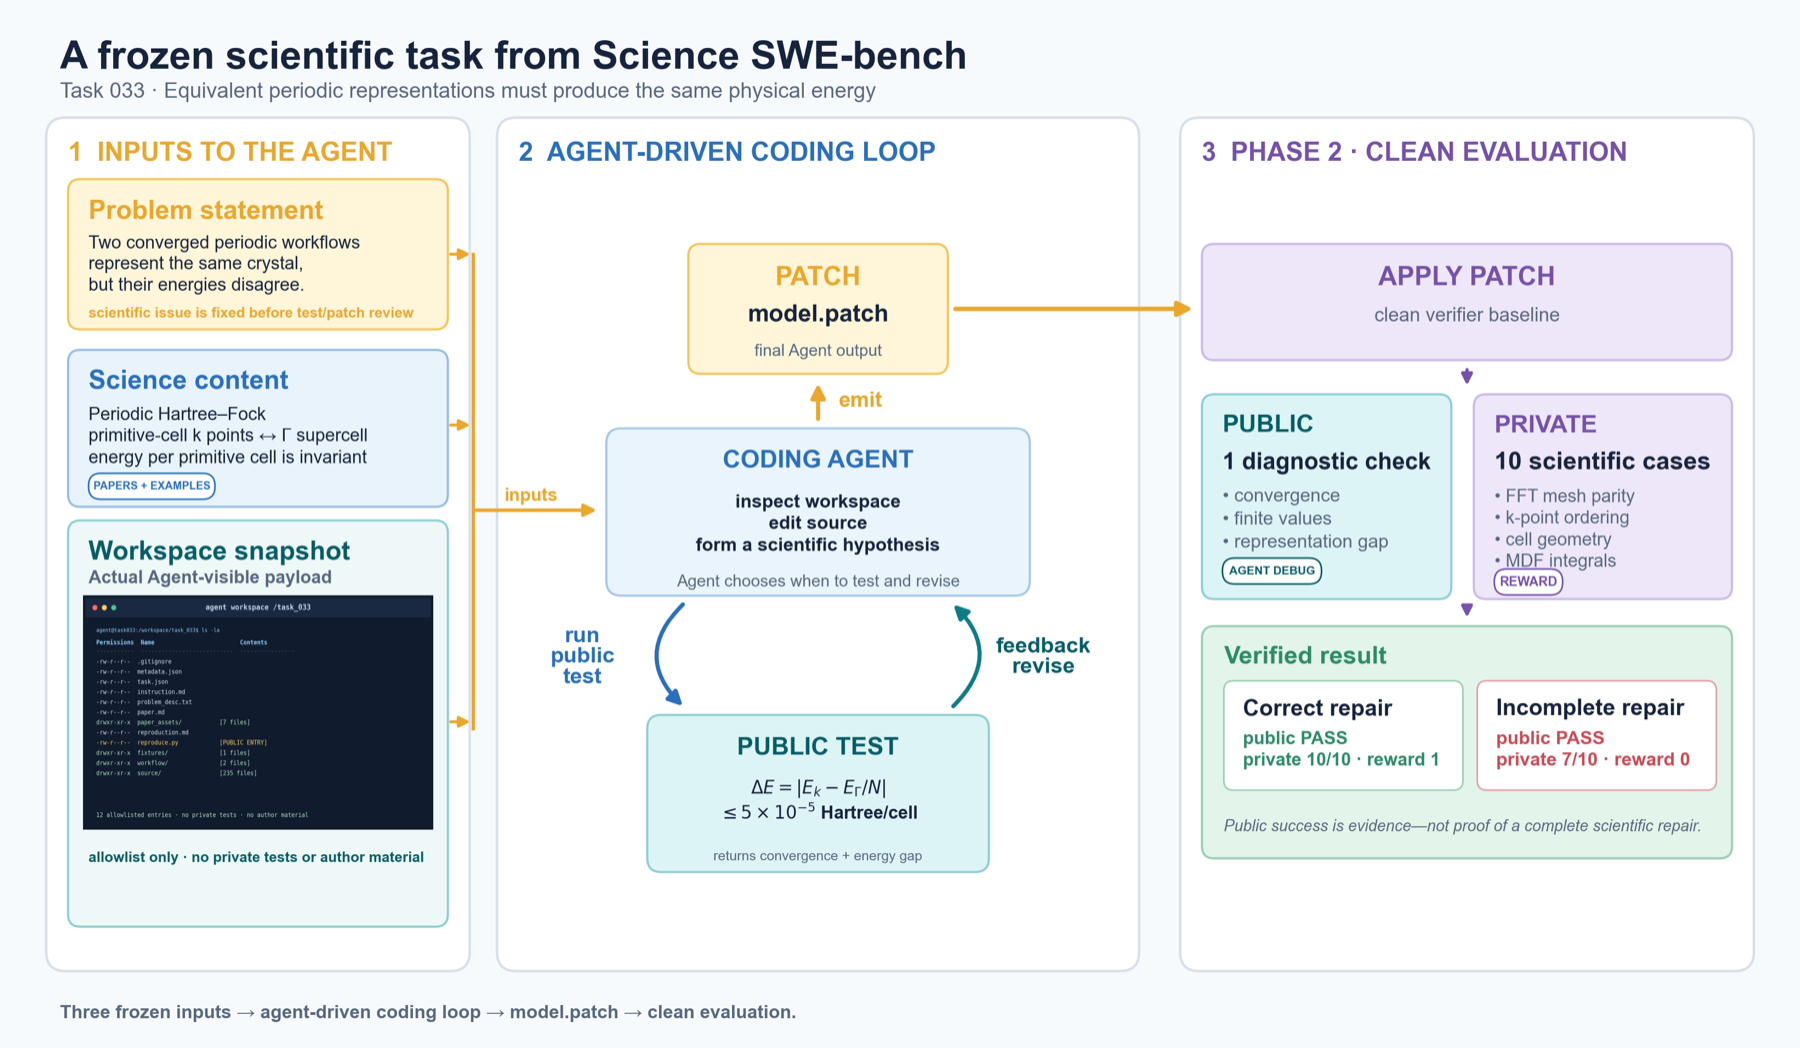
图4|科学任务的输入、智能体编码循环与公开/私有测试评测。
结果:即使是最强配置,仍然不到一半
在论文报告的代表性配置中,Claude Code + Opus-5(max) 的整体Pass@1最高,为47.90%,仍未达到一半。该配置的公开测试平均得分为96.64%,但完整私有测试的Pass@1明显更低。这说明:科学软件修复的难点,并不只是让一个可见示例通过,而是要理解完整的科学约束,并把修复落实到所有相关情形。
科学信息越多,效果就一定越好吗?
团队进一步在91个可以分离科学辅助信息的任务上做了配对比较。代码仓库、执行环境和评测目标保持不变,只改变是否向智能体提供论文摘录、科学原理、专家诊断等显式信息。结果并不统一:
对DeepSeek-V4-flash,加入科学信息后Pass@1从16.48%上升到23.08%;
对GPT-5.6-sol,加入科学信息后Pass@1从36.26%下降到31.87%。
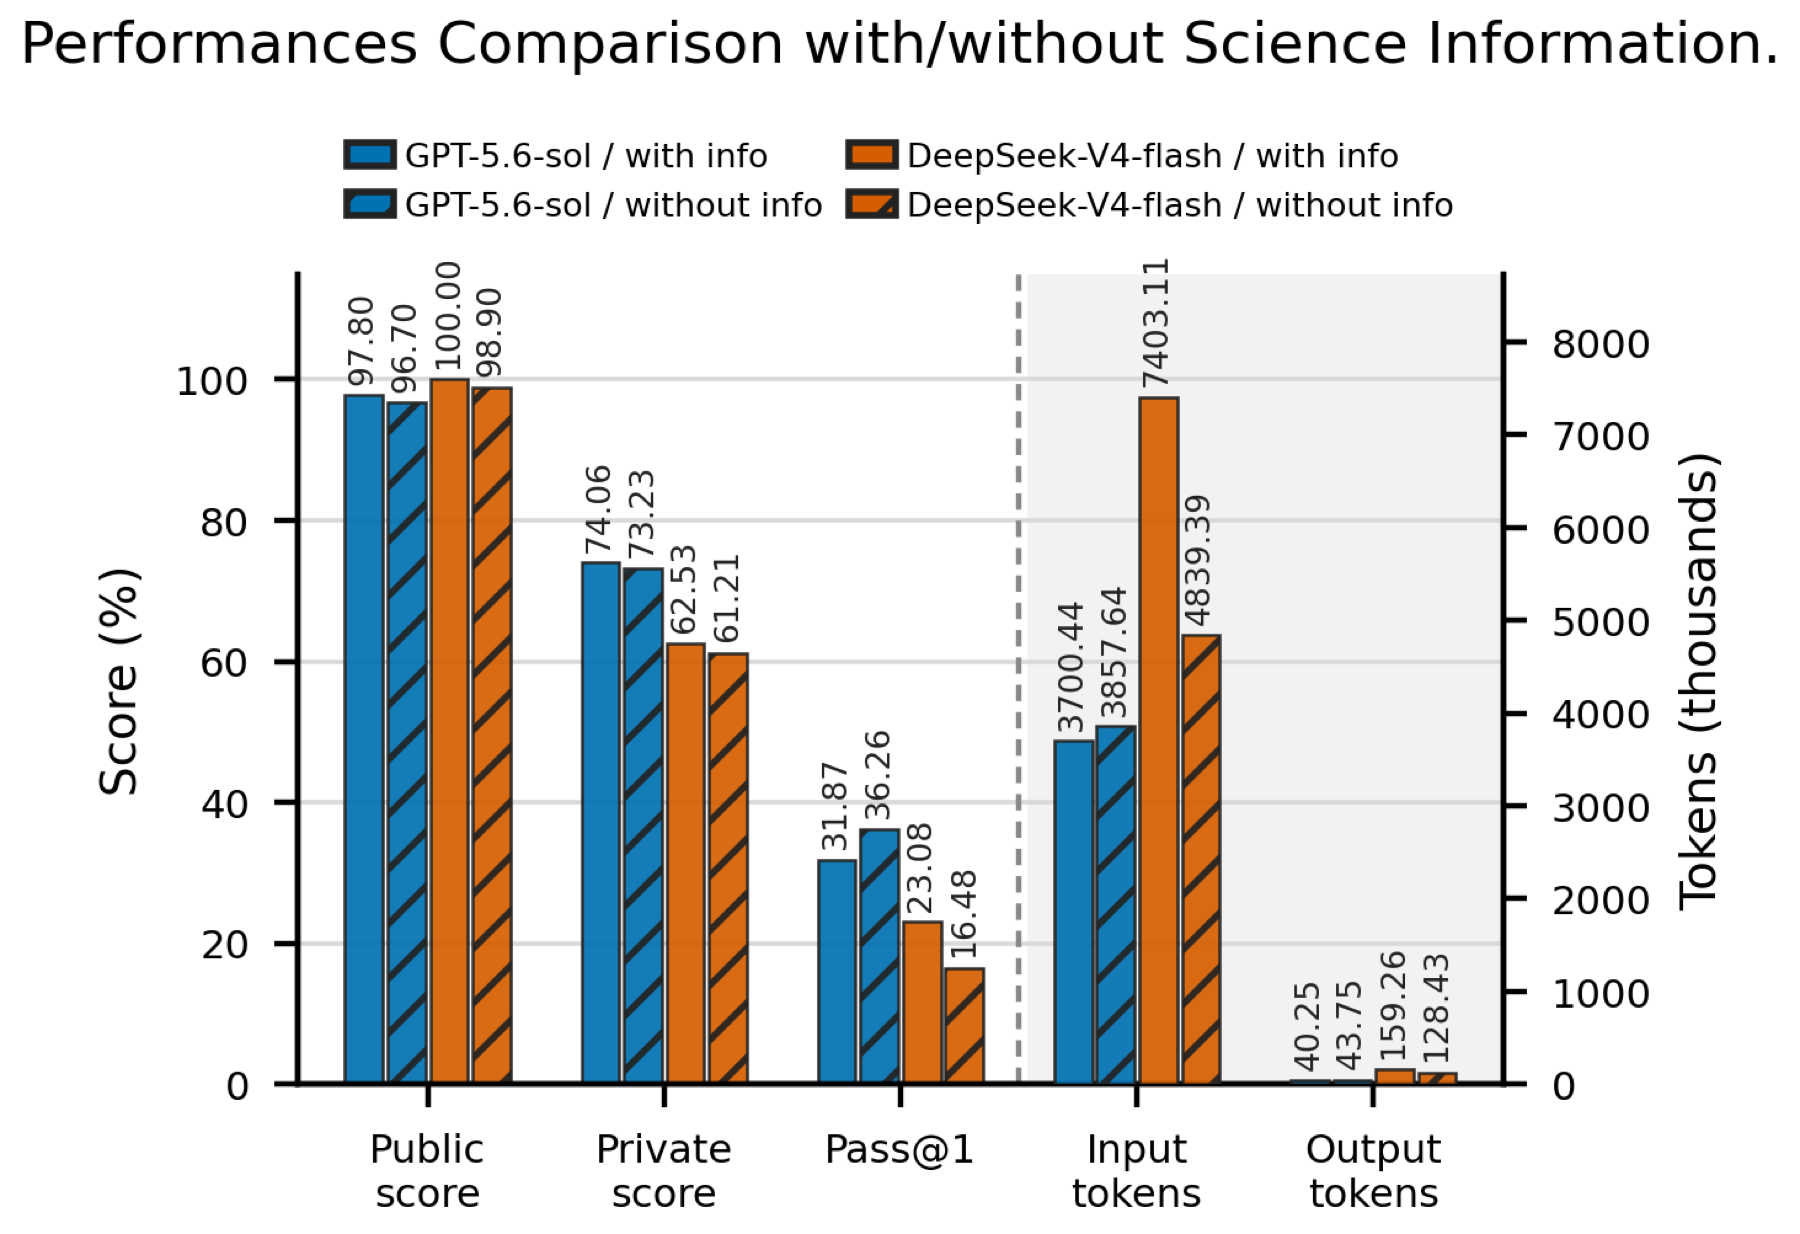
图5|科学信息消融实验的得分与token消耗。
这提示了,关键不只是“有没有科学知识”,还包括知识是否准确、是否与代码证据对齐,以及智能体能否通过执行和测试独立验证自己的判断。
AI在科学软件中最容易在哪些地方失败?
对失败尝试的分析显示,问题反复集中在四类机制:
科学知识或抽象不足:没有正确理解科学对象、数学定义或领域约束。
误导性探索或表面修复:只针对可见症状或公开指标打补丁,没有追到根因。
修复覆盖不足或系统集成不完整:局部改动看似合理,但模块交互、数据流或共享不变量没有一起修复。
科学知识泛化失败:只处理了观察到的案例,面对等价表示、边界条件或新情形时失效。
这些失败模式也说明,科学软件工程需要的不只是更强的代码生成能力,还包括科学抽象、系统性调试和可验证的推理过程。
让代码智能体真正理解科学软件
SWE-bench Science希望为研究者提供一个更贴近真实科学研发的软件工程测试场:
对模型开发者,它可以帮助定位智能体在科学任务中的具体短板;
对科学计算研究者,它可以提供跨领域、可复现的工程任务;
对更广泛的AI社区,它也提出了一个重要问题:代码通过测试之后,科学结论是否仍然可信?
论文、代码、数据集和排行榜已开放访问,欢迎大家使用、复现和反馈。
论文:https://arxiv.org/abs/2608.19799
代码:https://github.com/OpenMOSS/SWE-bench-Science
数据集:https://huggingface.co/datasets/OpenMOSS-Team/SWE-bench-Science
排行榜:https://swescience.github.io
SWE-bench Science由上海创智学院与复旦大学团队共同构建。